超越 BERT 和 GPT,微软亚洲研究院开源新模型 MASS
前言
BERT和XLNet在自然语言理解任务(例如:情感分类、自然语言推理和SQuAD阅读理解)方面取得了巨大成功。然而,NLP领域除了自然语言理解任务之外,还存在很多序列到序列的语言生成任务,例如机器翻译、文本摘要生成、对话生成、问答、文本风格转换等。对于这些任务,使用编码器-注意力-解码器框架是主流方法。
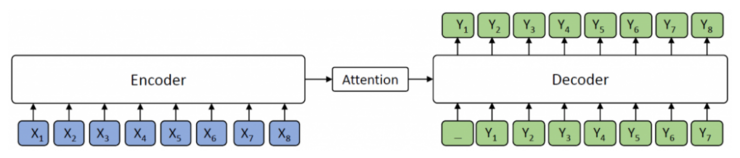
图1编码器-注意力-解码器框架
如图1所示,编码器将源序列X作为输入并将其转换为隐藏表示的序列,然后解码器通过注意力机制从编码器中抽象出隐藏表示的序列信息,并自动生成目标序列文本Y。
BERT和XLnet通常是对一个编码器进行自然语言理解的预训练;而GPT则是对一个解码器进行语言建模的预训练。当利用BERT和GPT进行序列到序列的语言生成任务时,我们通常需要对编码器和解码器分别进行预训练。在这种情况下,编码器-注意力-解码器框架和注意力机制并没有得到联合训练。然而,注意力机制在这类任务中极为重要,一旦缺失便会导致BERT和GPT无法达到最佳性能。
一种新的预训练方法针对序列到序列的自然语言生成任务,微软亚洲研究院的机器学习小组提出了一种新的预训练方法,即掩蔽的序列到序列预训练(MASS:MaskedSequencetoSequencePre-Training)。MASS随机掩蔽一个长度为k的句子片段,并通过编码器-注意力-解码器框架预测这一被掩蔽的片段。
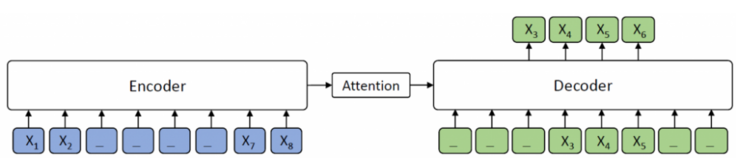
图2MASS框架
如图2所示,编码器端的第3-6个标记被掩蔽,而在解码器端,仅有被掩蔽的标记被预测出来,而其他标记则被掩蔽。
MASS预训练具有以下优势:
解码器端的其他标记(在编码器端未被掩蔽的标记)被掩蔽,从而推动解码器提取更多信息以帮助预测连续句子片段,促进编码器-注意力-解码器结构的联合训练;
为了给解码器提供更多有用的信息,编码器被强制提取未被掩蔽的标记的含义,这可以提高编码器理解源序列文本的能力;
解码器被设计用以预测连续的标记(句子片段),这可以提升解码器的语言建模能力。
统一的预训练框架MASS有一个重要的超参数k(被掩蔽的片段的长度)。通过调整k值,MASS可以将BERT中掩蔽的语言建模和GPT中的标准语言建模结合起来,从而将MASS扩展成一个通用的预训练框架。
当k=1时,根据MASS的设计,编码器端的一个标记被掩蔽,而解码器端则会预测出该掩蔽的标记,如图3所示。解码器端没有输入信息,因而MASS等同于BERT中掩蔽的语言模型。
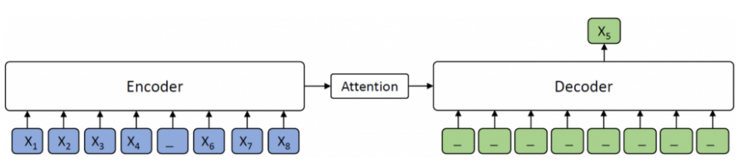
图3k=1时,编码器端一个标记被掩蔽,而解码器端则会预测出该掩蔽的标记
当k=m(m是序列的长度)时,在MASS中,编码器端的所有标记都被掩蔽,而解码器端会预测所有的标记,如图4所示。解码器端无法从编码器端提取任何信息,MASS等同于GPT中的标准语言模型。
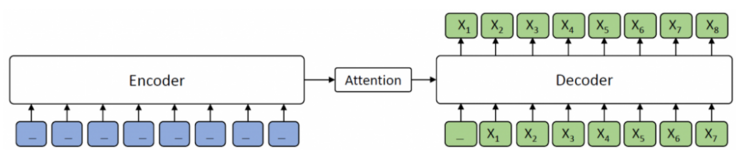
图4k=m时,编码器端的所有词都被掩蔽,而解码器端会预测所有的标记,等同于GPT中的标准语言模型
不同k值下MASS的概率公式如表1所示,其中m是序列的长度,u和v分别是掩蔽片段的起始和终止位置,
代表从位置u到v的标记都被掩蔽的序列。可以看出,当k=1或m时,MASS的概率公式等同于BERT中的被掩蔽的语言模型和GPT中的标准语言模型。
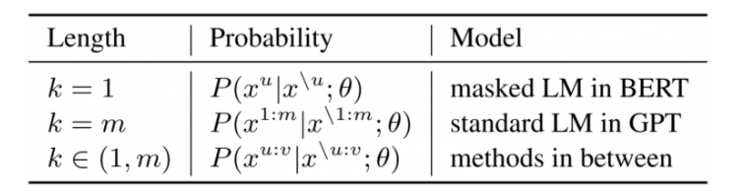
表1在不同k值下MASS的概率公式
研究人员通过实验来分析了在不同k值下的MASS性能,如图5所示:
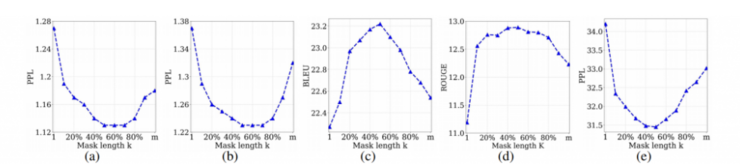
图5在训练前和微调阶段的各种掩蔽长度k下MASS的表现,其中包括a)英语句子预训练模型的PPLb)WMT13英语-法语翻译的法语句子c)WMT13无监督英语-法语翻译的BLEU值d)文本摘要生成的ROUGE值e)对话生成的PPL
当k等于句子长度的一半时,下游任务可以达到其最佳性能。掩蔽句子中一半的词可以很好地平衡编码器和解码器的预训练部分。如果预训练更偏向编码器端(k=1,即BERT)或更偏向解码器端(k=m,LM/GPT),则无法实现最优的性能,这也表现出了MASS在序列到序列的语言生成任务中的优势。
序列到序列的语言生成任务测试预训练
值得注意的是,MASS仅需要无监督的单语数据进行预训练(例如WMTNewsCrawlData、WikipediaData等)。MASS支持跨语言任务(例如机器翻译)和单语任务(例如文本摘要生成、对话生成)。在对英语-法语翻译等跨语言任务进行预训练时,研究人员可以在一个模型中同时进行英语-英语和法语-法语的预训练,并使用附加的语言嵌入向量来区分语言。在无监督的机器翻译、低资源机器翻译、文本摘要生成和对话生成四个领域,研究人员对MASS进行了微调,以验证其有效性。
无监督机器翻译
关于无监督机器翻译任务,研究人员将MASS与之前的方法进行了比较,包括以前最先进的方法FacebookXLM。XLM使用了由BERT创建的掩蔽预训练语言模型,以及标准语言模型来分别预训练编码器和解码器。
结果如表2所示,MASS在WMT14英语-法语、WMT16英语-德语和英语-罗马尼亚语的六个翻译方向上的表现都优于XLM,并取得了最新的最优结果。
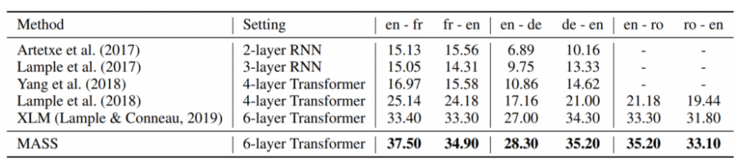
表2MASS与之前关于无监督机器翻译方法之间的比较;英语-法语翻译报道在newstest2014上,其它的在newstest2016可以找到;由于XLM在编码器和解码器中使用MLM和CLM的不同组合,因此报告上显示的是每个语言对上XLM的最高BLEU值
低资源机器翻译
低资源机器翻译是指使用有限的双语训练数据来进行机器翻译。研究人员模拟了WMT14英语-法语,WMT16英语-德语和英语-罗马尼亚语翻译(分别为10K,100K和1M双语数据)的低资源情景。
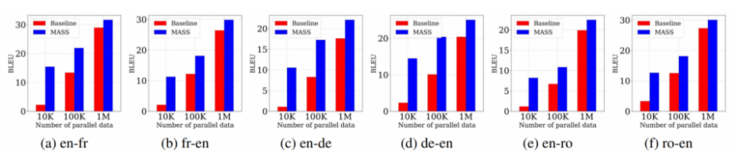
图6MASS与低资源机器翻译方法之间的比较
图6显示MASS在不同数据规模上的表现,均比不用预训练的基线模型有不同程度的提升,并随着监督数据越少,提升效果越显著。
文本摘要生成
研究人员将MASS与BERT+LM(编码器用BERT预训练,解码器用标准语言模型LM预训练)、DAE(去噪自编码器)进行了比较。从表3中可以看出,MASS的表现都优于BERT+LM和DAE。
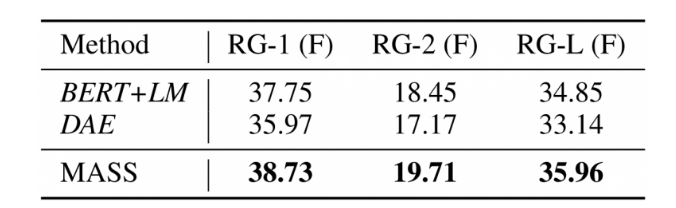
表3文本摘要生成任务中,MASS和两种预训练方法之间的比较
对话生成
研究人员将MASS和BERT+LM进行了比较。表4显示MASS实现了比BERT+LM更低的PPL。
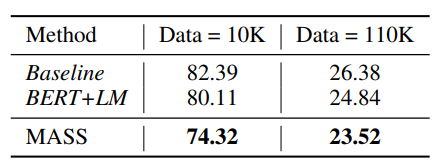
表4MASS与BERT+LM之间的比较数据
原文地址
MASS论文
GitHub开源地址