「Python从零到壹」 十二.机器学习之回归分析万字总结全网首发
监督学习(SupervisedLearning)包括分类算法(Classification)和回归算法(Regression)两种,它们是根据类别标签分布的类型来定义的。回归算法用于连续型的数据预测,分类算法用于离散型的分布预测。回归算法作为统计学中最重要的工具之一,它通过建立一个回归方程用来预测目标值,并求解这个回归方程的回归系数。
一.回归1.什么是回归回归(Regression)最早是英国生物统计学家高尔顿和他的学生皮尔逊在研究父母和子女的身高遗传特性时提出的。1855年,他们在《遗传的身高向平均数方向的回归》中这样描述“子女的身高趋向于高于父母的身高的平均值,但一般不会超过父母的身高”,首次提出来回归的概念。现在的回归分析已经和这种趋势效应没有任何瓜葛了,它只是指源于高尔顿工作,用一个或多个自变量来预测因变量的数学方法。
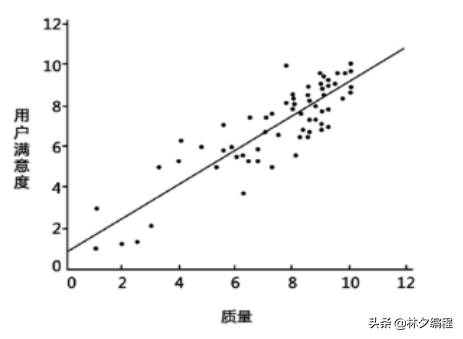
图1是一个简单的回归模型,X坐标是质量,Y坐标是用户满意度,从图中可知,产品的质量越高其用户评价越好,这可以拟合一条直线来预测新产品的用户满意度。
在回归模型中,我们需要预测的变量叫做因变量,比如产品质量;选取用来解释因变量变化的变量叫做自变量,比如用户满意度。回归的目的就是建立一个回归方程来预测目标值,整个回归的求解过程就是求这个回归方程的回归系数。
简言之,回归最简单的定义就是:
给出一个点集,构造一个函数来拟合这个点集,并且尽可能的让该点集与拟合函数间的误差最小,如果这个函数曲线是一条直线,那就被称为线性回归,如果曲线是一条三次曲线,就被称为三次多项回归。
2.线性回归首先,作者引用类似于斯坦福大学机器学习公开课线性回归的例子,给大家讲解线性回归的基础知识和应用,方便大家的理解。同时,作者强烈推荐大家学习原版AndrewNg教授的斯坦福机器学习公开课,会让您非常受益。
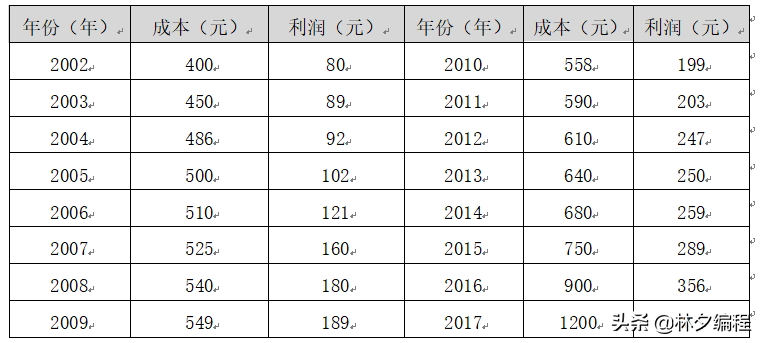
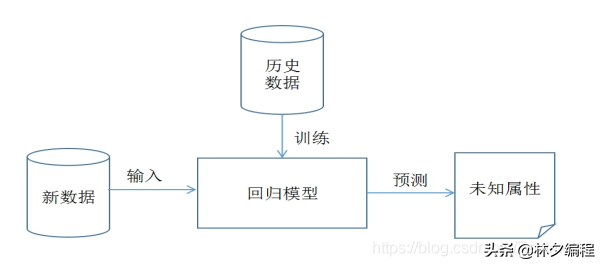
假设存在表1的数据集,它是某企业的成本和利润数据集。数据集中2002年到2016年的数据集称为训练集,整个训练集共15个样本数据。重点是成本和利润两个变量,成本是输入变量或一个特征,利润是输出变量或目标变量,整个回归模型如图2所示。
现建立模型,x表示企业成本,y表示企业利润,h(Hypothesis)表示将输入变量映射到输出变量y的函数,对应一个因变量的线性回归(单变量线性回归)公式如下:
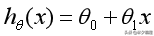
那么,现在要解决的问题是如何求解的两个参数和。我们的构想是选取的参数和使得函数尽可能接近y值,这里提出了求训练集(x,y)的平方误差函数(SquaredErrorFunction)或最小二乘法。
在回归方程里,最小化误差平方和方法是求特征对应回归系数的最佳方法。误差是指预测y值和真实y值之间的差值,使用误差的简单累加将使得正差值和负差值相互抵消,所采用的平方误差(最小二乘法)如下:
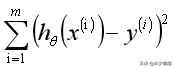
在数学上,求解过程就转化为求一组值使上式取到最小值,最常见的求解方法是梯度下降法(GradientDescent)。根据平方误差,定义该线性回归模型的损耗函数(CostFunction)为,公式如下:
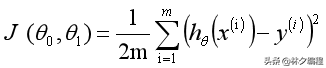
选择适当的参数让其最小化min,即可实现拟合求解过程。通过上面的这个示例,我们就可以对线性回归模型进行如下定义:根据样本x和y的坐标,去预估函数h,寻求变量之间近似的函数关系。公式如下:
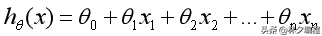
其中,n表示特征数目,表示每个训练样本的第i个特种值,当只有一个因变量x时,称为一元线性回归,类似于;而当多个因变量时,成为多元线性回归。我们的目的是使最小化,从而最好的将样本数据集进行拟合,更好地预测新的数据。
二.线性回归分析线性回归是数据挖掘中基础的算法之一,其核心思想是求解一组因变量和自变量之间的方程,得到回归函数,同时误差项通常使用最小二乘法进行计算。在本书常用的Sklaern机器学习包中将调用Linear_model子类的LinearRegression类进行线性回归模型计算。
1.LinearRegressionLinearRegression回归模型在_model子类下,主要是调用fit(x,y)函数来训练模型,其中x为数据的属性,y为所属类型。sklearn中引用回归模型的代码如下:
fromsklearnimportlinear_model使用线性回归print(regr)
输出函数的构造方法如下:
LinearRegression(copy_X=True,fit_intercept=True,n_jobs=1,normalize=False)
其中参数说明如下:
copy_X:布尔型,默认为True。是否对X复制,如果选择False,则直接对原始数据进行覆盖,即经过中心化、标准化后,把新数据覆盖到原数据上。
fit_intercept:布尔型,默认为True。是否对训练数据进行中心化,如果是True表示对输入的训练数据进行中心化处理,如果是False则输入数据已经中心化处理,后面的过程不再进行中心化处理。
n_jobs:整型,默认为1。计算时设置的任务个数,如果设置为-1表示使用所有的CPU。该参数对于目标个数大于1且规模足够大的问题有加速作用。
normalize:布尔型,默认为False。是否对数据进行标准化处理。
LinearRegression类主要包括如下方法:
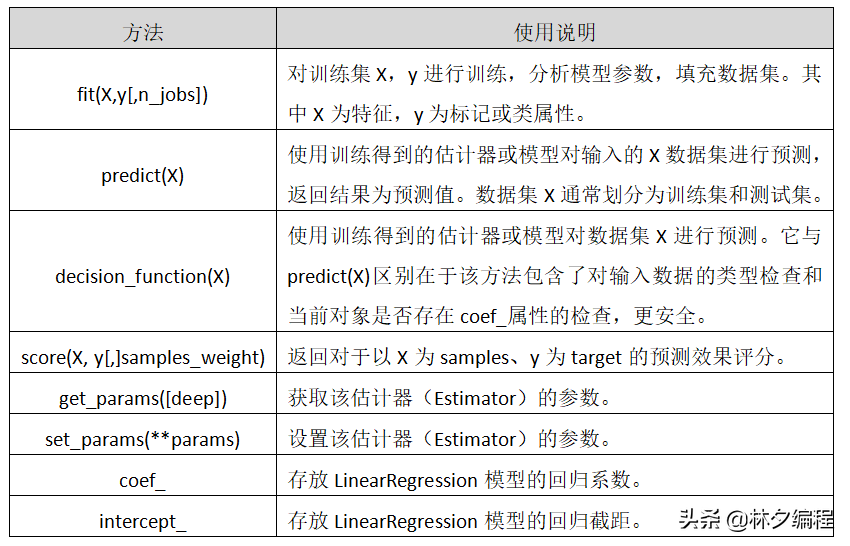
fit(X,y[,n_jobs])
对训练集X,y进行训练,分析模型参数,填充数据集。其中X为特征,y为标记或类属性。
predict(X)
使用训练得到的估计器或模型对输入的X数据集进行预测,返回结果为预测值。数据集X通常划分为训练集和测试集。
decision_function(X)
使用训练得到的估计器或模型对数据集X进行预测。它与predict(X)区别在于该方法包含了对输入数据的类型检查和当前对象是否存在coef_属性的检查,更安全。
score(X,y[,]samples_weight)
返回对于以X为samples、y为target的预测效果评分。
get_params([deep])
获取该估计器(Estimator)的参数。
**set_params(params)
设置该估计器(Estimator)的参数。
coef_
存放LinearRegression模型的回归系数。
intercept_
存放LinearRegression模型的回归截距。
现在对前面的企业成本和利润数据集进行线性回归实验。完整代码如下:
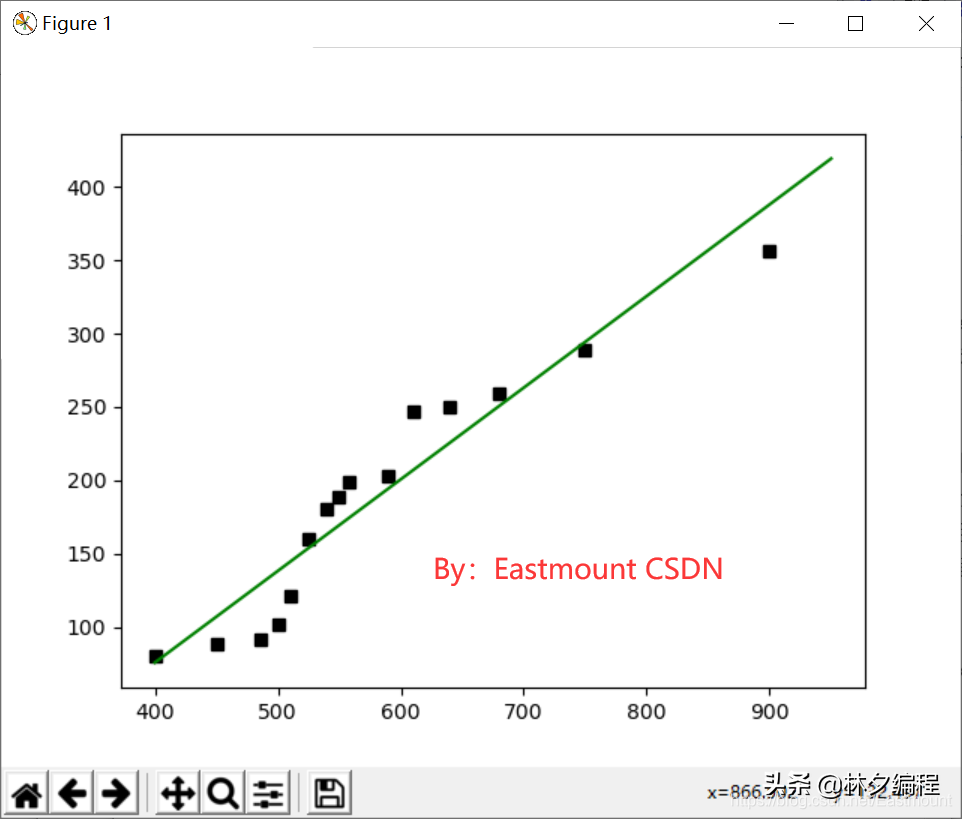
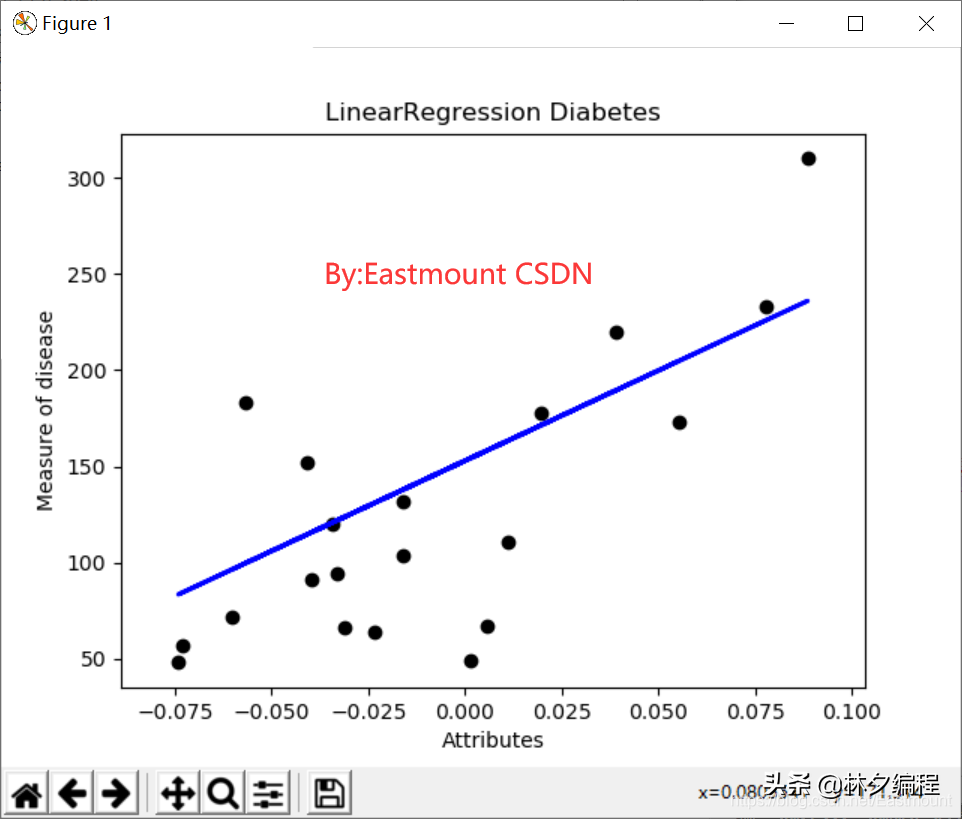
By:EastmountCSDN2021-07-03fromsklearnimportlinear_modelX表示企业成本Y表示企业利润X=[[400],[450],[486],[500],[510],[525],[540],[549],[558],[590],[610],[640],[680],[750],[900]]Y=[[80],[89],[92],[102],[121],[160],[180],[189],[199],[203],[247],[250],[259],[289],[356]]print('数据集X:',X)print('数据集Y:',Y)预测结果X2=[[400],[750],[950]]Y2=(X2)print(Y2)res=(([1200]).reshape(-1,1))[0]print('预测成本1200元的利润:$%.1f'%res)绘制训练数据集散点图(X2,Y2,'g-')-*-coding:utf-8-*-载入数据print()类标print('总行数:',len(),len())print('特征数:',len([0]))-*-coding:utf-8-*-数据集划分diabetes=_diabetes()获取其中一个特征diabetes_x_train=diabetes_x_temp[:-20]测试样本后20行diabetes_y_train=[:-20]预测对比标记训练数据集pre=(diabetes_x_test)标题(u'Attributes')y轴坐标(diabetes_x_test,diabetes_y_test,color='black')预测直线()输出结果如图5所示,每个点表示真实的值,而直线表示预测的结果。
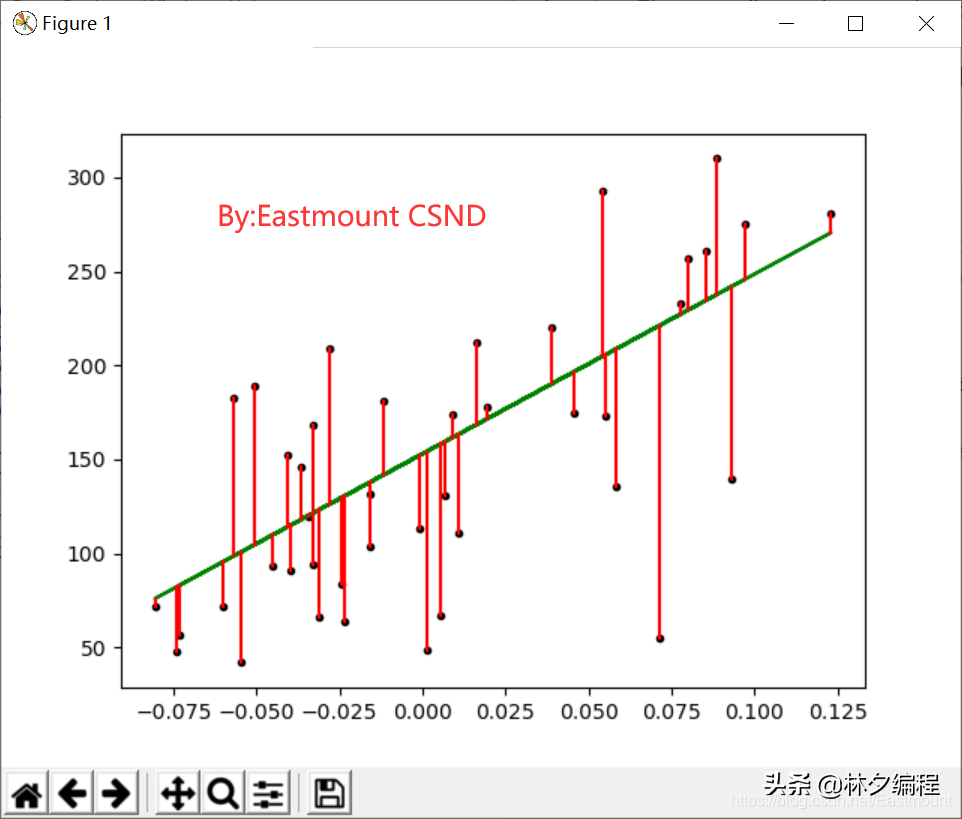
下面代码增加了几个优化措施,包括增加了斜率、截距的计算,可视化绘图增加了散点到线性方程的距离线,增加了保存图片设置像素代码等。这些优化都更好地帮助我们分析真实的数据集。
By:EastmountCSDN2021-07-03fromsklearnimportdatasetsimportnumpyasnpfromsklearnimportlinear_数据10*442x=_one=x[:,,2]获取的正确结果x_train=x_one[:-42]预测集X[401:442]y_train=y[:-42]预测集Y[401:442]第三步评价结果cost=(y_test-pre)**2第四步绘图(x_test,y_test,'k.')预测回归直线保存图片()
绘制的图形如图6所示。
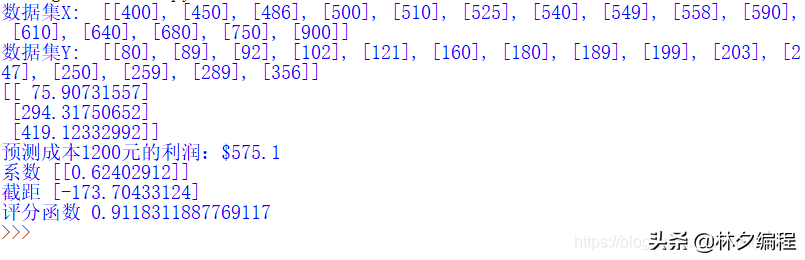
输出结果如下:
LinearRegression(copy_X=True,fit_intercept=True,n_jobs=1,normalize=False)预测结果[196.51241167109.98667708121.31742804245.95568858204.75295782270.6773270375.99442421241.8354155104.83633574141.91879342126.46776938208.8732309234.62493762152.21947611159.42995399161.49009053229.47459628221.23405012129.55797419100.71606266118.22722323168.70056841227.41445974115..55022706114.10695016120.28735977158.39988572237.71514243121.3174280498.65592612123.37756458205.7830260995.56572131154.27961264130.5880424682..79077322137.79852034137.79852034190.3320020683.20490209]真实结果[175.93.168.275.293.281.72.140.189.181.209.136.261.113.131.174.257.55.84.42.146.212.233.91.111.152.120.67.310.94.183.66.173.72.49.64.48.178.104.132.220.57.]平方和计算:83.192340827系数[955.70303385]截距153.000183957方差0.427204267067
其中cost=(y_test-pre)**2表示计算预测结果和真实结果之间的平方和,为83.192340827,根据系数和截距得出其方程为:y=955.70303385*x+153.000183957。
三.多项式回归分析1.基础概念线性回归研究的是一个目标变量和一个自变量之间的回归问题,但有时候在很多实际问题中,影响目标变量的自变量往往不止一个,而是多个,比如绵羊的产毛量这一变量同时受到绵羊体重、胸围、体长等多个变量的影响,因此需要设计一个目标变量与多个自变量间的回归分析,即多元回归分析。由于线性回归并不适用于所有的数据,我们需要建立曲线来适应我们的数据,现实世界中的曲线关系很多都是增加多项式实现的,比如一个二次函数模型:
再或者一个三次函数模型:
这两个模型我们绘制的图形如下所示:
多项式回归(PolynomialRegression)是研究一个因变量与一个或多个自变量间多项式的回归分析方法。如果自变量只有一个时,称为一元多项式回归;如果自变量有多个时,称为多元多项式回归。在一元回归分析中,如果依变量y与自变量x的关系为非线性的,但是又找不到适当的函数曲线来拟合,则可以采用一元多项式回归。17.3小节主要讲解一元多次的多项式回归分析,一元m次多项式方程如下:
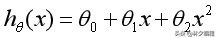
其方程的求解过程希望读者下来自行学习,接下来作者主要讲解Python如何代码实现多项式回归分析的。
2.PolynomialFeaturesPython的多项式回归需要导入子类中PolynomialFeatures类实现。PolynomialFeatures对应的函数原型如下:
(degree=2,interaction_only=False,include_bias=True)
PolynomialFeatures类在Sklearn官网给出的解释是:专门产生多项式的模型或类,并且多项式包含的是相互影响的特征集。共有三个参数,degree表示多项式阶数,一般默认值是2;interaction_only如果值是true(默认是False),则会产生相互影响的特征集;include_bias表示是否包含偏差列。
PolynomialFeatures类通过实例化一个多项式,建立等差数列矩阵,然后进行训练和预测,最后绘制相关图形,接下来与前面的一元线性回归分析进行对比试验。
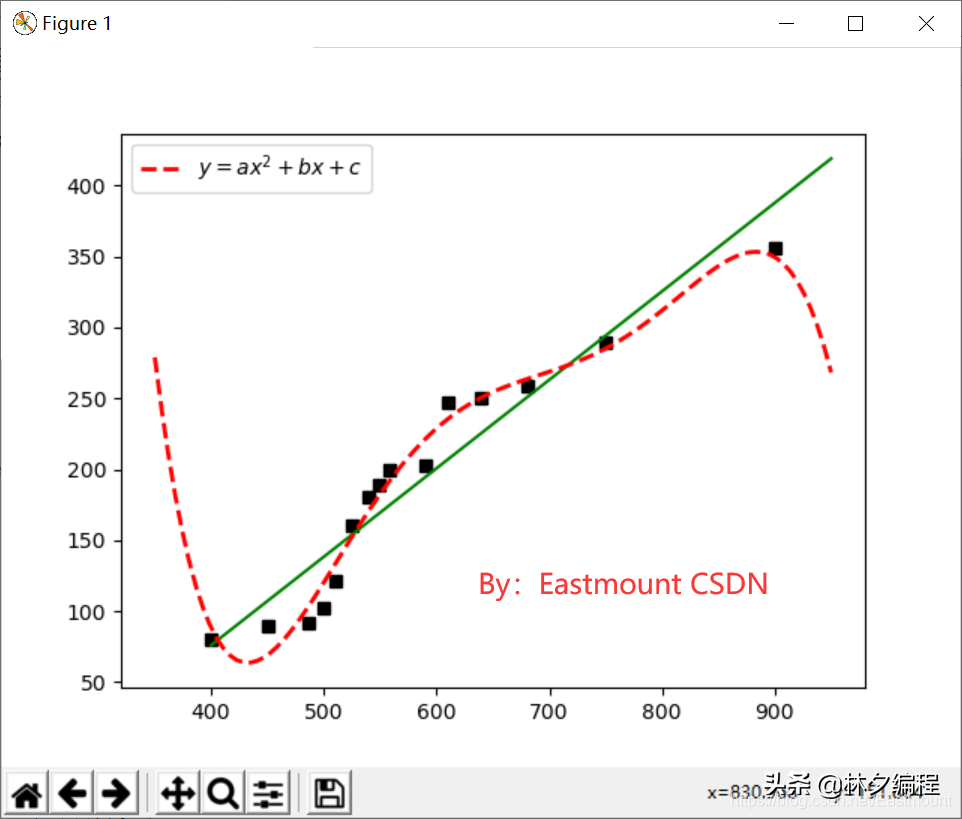
3.多项式回归预测成本和利润本小节主要讲解多项式回归分析实例,分析的数据集是表17.1提供的企业成本和利润数据集。下面直接给出线性回归和多项式回归分析对比的完整代码和详细注释。
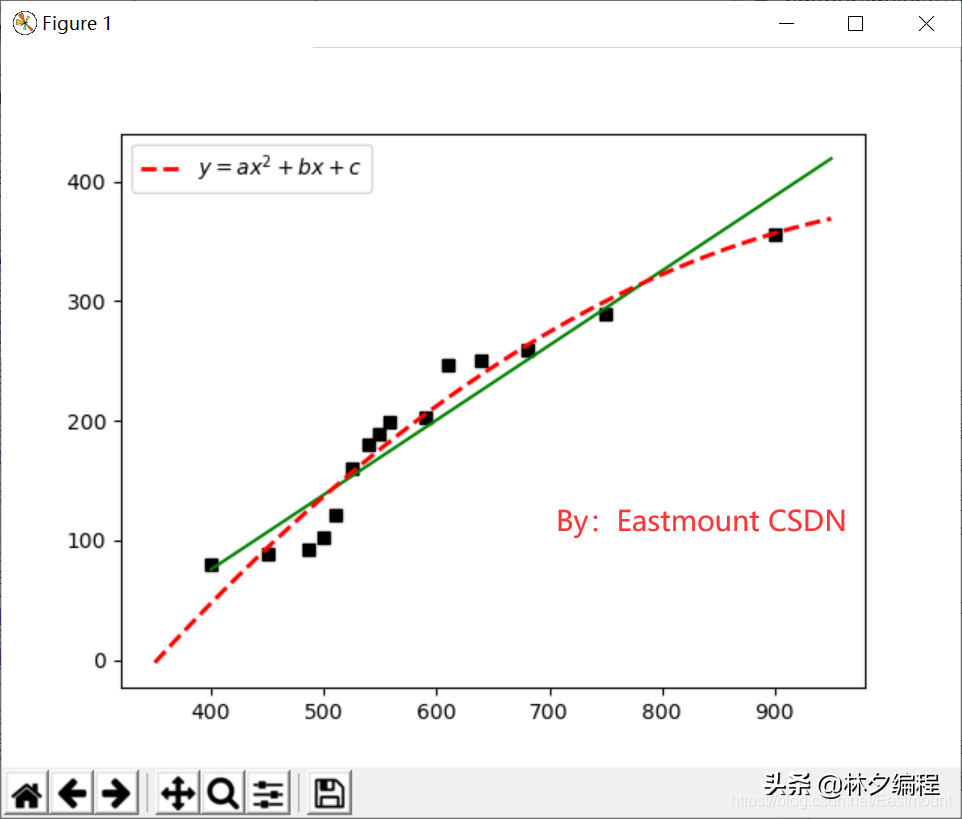
By:_第一步线性回归分析clf=LinearRegression()(X,Y)X2=[[400],[750],[950]]Y2=(X2)print(Y2)res=(([1200]).reshape(-1,1))[0]print('预测成本1200元的利润:$%.1f'%res)(X,Y,'ks')绘制预测数据集直线350到950等差数列quadratic_featurizer=PolynomialFeatures(degree=2)用二次多项式x做变换X_test_quadratic=quadratic_(X2)regressor_quadratic=LinearRegression()regressor_(x_train_quadratic,Y)34;,linewidth=2)()()输出图形如下图所示,其中黑色散点图表示真实的企业成本和利润的关系,绿色直线为一元线性回归方程,红色虚曲线为二次多项式方程。它更接近真实的散点图。
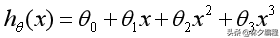
这里我们使用R方(R-Squared)来评估多项式回归预测的效果,R方也叫确定系数(CoefficientofDetermination),它表示模型对现实数据拟合的程度。计算R方的方法有几种,一元线性回归中R方等于皮尔逊积矩相关系数(PearsonProductMomentCorrelationCoefficient)的平方,该方法计算的R方是一定介于0~1之间的正数。另一种是Sklearn库提供的方法来计算R方。R方计算代码如下:
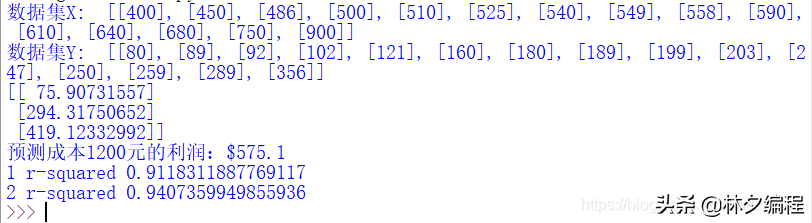
print('1r-squared',(X,Y))print('2r-squared',regressor_(x_train_quadratic,Y))输出如下所示:
('1r-squared',0.91025)('2r-squared',0.94073599498559335)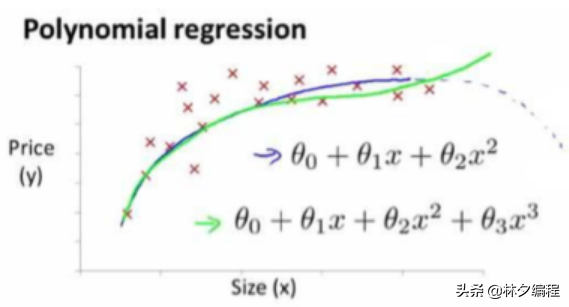
一元线性回归的R方值为0.9118,多项式回归的R方值为0.9407,说明数据集中超过94%的价格都可以通过模型解释。最后补充5次项的拟合过程,下面只给出核心代码。
By:_第一步线性回归分析clf=LinearRegression()(X,Y)X2=[[400],[750],[950]]Y2=(X2)print(Y2)res=(([1200]).reshape(-1,1))[0]print('预测成本1200元的利润:$%.1f'%res)(X,Y,'ks')绘制预测数据集直线把训练好X值的多项式特征实例应用到一系列点上,形成矩阵xx_quadratic=quadratic_(([0],1))(xx,regressor_(xx_quadratic),"r--",label="$y=ax^2+bx+c('1r-squared',0.91025)-*-coding:utf-8-*-Sigmoid函数(x,h)(0.0,color='k')y轴标度(-0.1,1.1)-*-coding:utf-8-*-导入逻辑回归模型clf=LogisticRegression()print(clf)(train_feature,label)predict['label']=(predict_feature)输出函数的构造方法如下:
LogisticRegression(C=1.0,class_weight=None,dual=False,fit_intercept=True,intercept_scaling=1,max_iter=100,multi_class='ovr',n_jobs=1,penalty='l2',random_state=None,solver='liblinear',tol=0.0001,verbose=0,warm_start=False)
这里仅介绍两个参数:参数penalty表示惩罚项,包括两个可选值L1和L2。L1表示向量中各元素绝对值的和,常用于特征选择;L2表示向量中各个元素平方之和再开根号,当需要选择较多的特征时,使用L2参数,使他们都趋近于0。C值的目标函数约束条件为:||w||1C,默认值是0,C值越小,则正则化强度越大。
3.鸢尾花数据集回归分析实例下面将结合Scikit-learn官网的逻辑回归模型分析鸢尾花数据集。由于该数据分类标签划分为3类(0类、1类、2类),属于三分类问题,所以能利用逻辑回归模型对其进行分析。
(1).鸢尾花数据集
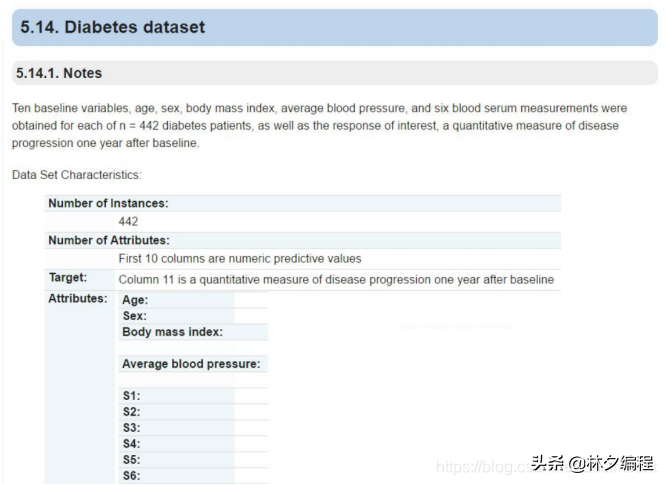
在Sklearn机器学习包中,集成了各种各样的数据集,包括前面的糖尿病数据集,这里引入的是鸢尾花卉(Iris)数据集,它也是一个很常用的数据集。该数据集一共包含4个特征变量,1个类别变量,共有150个样本。其中四个特征分别是萼片的长度和宽度、花瓣的长度和宽度,一个类别变量是标记鸢尾花所属的分类情况,该值包含三种情况,即山鸢尾(Iris-setosa)、变色鸢尾(Iris-versicolor)和维吉尼亚鸢尾(Iris-virginica)。鸢尾花数据集详细介绍如表2所示:
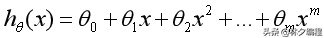
Class类别变量。0表示山鸢尾,1表示变色鸢尾,2表示维吉尼亚鸢尾。int
iris里有两个属性,。data是一个矩阵,每一列代表了萼片或花瓣的长宽,一共4列,每一行代表一个被测量的鸢尾植物,一共采样了150条记录,即150朵鸢尾花样本。
_iris载入数据集print()
输出如下所示:
[[5.13.51.40.2][4.93.1.40.2][4.73.21.30.2][4.63.11.50.2].[6.73.5.22.3][6.32.55.1.9][6.53.5.22.][6.23.45.42.3][5.93.5.11.8]]
target是一个数组,存储了每行数据对应的样本属于哪一类鸢尾植物,要么是山鸢尾(值为0),要么是变色鸢尾(值为1),要么是维吉尼亚鸢尾(值为2),数组的长度是150。
print()150个样本每个样本4个特征print()[000000000000000000000000000000000000000000000000001111111111111111111111111111111111111111111111111122222222222222222222222222222222222222222222222222]150(150L,4L)
从输出结果可以看到,类标共分为三类,前面50个类标位0,中间50个类标位1,后面为2。下面给详细介绍使用逻辑回归对这个数据集进行分析的代码。
(2).散点图绘制
在载入了鸢尾花数据集(数据data和标签target)之后,我们需要获取其中两列数据或两个特征,再调用scatter()函数绘制散点图。其中获取一个特征的核心代码为:X=[x[0]forxinDD],将获取的值赋值给X变量。完整代码如下:
By:_iris载入数据集iris=load_iris()print()输出真实标签(X,Y,c=,marker='x')(X[:50],Y[:50],color='red',marker='o',label='setosa')中间50个(X[100:],Y[100:],color='green',marker='+',label='Virginica')左上角()
输出如图11所示:
(3).线性回归分析
下述代码先获取鸢尾花数据集的前两列数据,再调用Sklearn库中线性回归模型进行分析,完整代码如文件所示。
By:EastmountCSDN2021-07-03获取花瓣的长和宽x=[n[0]]y=[n[1]]importnumpyasnp第二步线性回归分析_modelimportLinearRegressionclf=LinearRegression()(x,y)pre=(x)print(pre)-*-coding:utf-8-*-载入数据集iris=load_iris()X=X=[:,:2]逻辑回归模型lr=LogisticRegression(C=1e5)(X,Y)pcolormesh函数将xx,yy两个网格矩阵和对应的预测结果Z绘制在图片上Z=(_[(),()])Z=()(1,figsize=(8,6))(xx,yy,Z,cmap=)#绘制散点图(X[:50,0],X[:50,1],color='red',marker='o',label='setosa')(X[50:100,0],X[50:100,1],color='blue',marker='x',label='versicolor')(X[100:,0],X[100:,1],color='green',marker='s',label='Virginica')('Sepallength')('Sepalwidth')((),())((),())(())(())(loc=2)()输出如图13所示。经过逻辑回归后划分为三个区域,左上角部分为红色的圆点,对应setosa鸢尾花;右上角部分为绿色方块,对应virginica鸢尾花;中间下部分为蓝色星形,对应versicolor鸢尾花。散点图为各数据点真实的花类型,划分的三个区域为数据点预测的花类型,预测的分类结果与训练数据的真实结果结果基本一致,部分鸢尾花出现交叉。
下面作者对导入数据集后的代码进行详细讲解。
lr=LogisticRegression(C=1e5)
初始化逻辑回归模型,C=1e5表示目标函数。
(X,Y)
调用逻辑回归模型进行训练,参数X为数据特征,参数Y为数据类标。
x_min,x_max=X[:,0].min()-.5,X[:,0].max()+.5
y_min,y_max=X[:,1].min()-.5,X[:,1].max()+.5
xx,yy=((x_min,x_max,h),(y_min,y_max,h))
获取鸢尾花数据集的两列数据,对应为花萼长度和花萼宽度,每个点的坐标就是(x,y)。先取X二维数组的第一列(长度)的最小值、最大值和步长h(设置为0.02)生成数组,再取X二维数组的第二列(宽度)的最小值、最大值和步长h生成数组,最后用meshgrid函数生成两个网格矩阵xx和yy,如下所示:
[[3.83.823.84,8.368.388.4][3.83.823.84,8.368.388.4],[3.83.823.84,8.368.388.4][3.83.823.84,8.368.388.4]][[1.51.51.5,1.51.51.5][1.521.521.52,1.521.521.52],[4.884.884.88,4.884.884.88][4.94.94.9,4.94.94.9]]
Z=(_[(),()])
调用ravel()函数将xx和yy的两个矩阵转变成一维数组,由于两个矩阵大小相等,因此两个一维数组大小也相等。_[(),()]是获取并合并成矩阵,即:
()[3.83.823.84,8.368.388.4]()[1.51.51.5,4.94.94.9]_[(),()][[3.81.5][3.821.5][3.841.5],[8.364.9][8.384.9][8.44.9]]
总之,上述操作是把第一列花萼长度数据按h取等分作为行,并复制多行得到xx网格矩阵;再把第二列花萼宽度数据按h取等分作为列,并复制多列得到yy网格矩阵;最后将xx和yy矩阵都变成两个一维数组,再调用_[]函数将其组合成一个二维数组进行预测。
Z=(_[(),()])
调用predict()函数进行预测,预测结果赋值给Z。即:
Z=(_[(),()])[111,222]size:39501
Z=()
调用reshape()函数修改形状,将Z变量转换为两个特征(长度和宽度),则39501个数据转换为171*231的矩阵。Z=()输出如下:
[[111,222][111,222][011,222],[000,222][000,222][000,222]]
(xx,yy,Z,cmap=)
调用pcolormesh()函数将xx、yy两个网格矩阵和对应的预测结果Z绘制在图片上,可以发现输出为三个颜色区块,分布表示分类的三类区域。cmap=表示绘图样式选择Paired主题,输出区域如下图所示:
(X[:50,0],X[:50,1],color=‘red’,marker=‘o’,label=‘setosa’)
调用scatter()绘制散点图,第一个参数为第一列数据(长度),第二个参数为第二列数据(宽度),第三、四个参数为设置点的颜色为红色,款式为圆圈,最后标记为setosa。
五.本章小结回归分析是通过建立一个回归方程用来预测目标值,并求解这个回归方程的回归系数的方法。它是统计学中最重要的工具之一,包括线性回归、多项式回归、逻辑回归、非线性回归等。常用来确定变量之间是否存在相关关系,并找出数学表达式,也可以通过控制几个变量的值来预测另一个变量的值,比如房价预测、增长趋势、是否患病等问题。
在Python中,我们通过调用Sklearn机器学习库的LinearRegression模型实现线性回归分析,调用PolynomialFeatures模型实现多项式回归分析,调用LogisticRegression模型实现逻辑回归分析。希望读者实现本章节中的每一部分代码,从而更好的用于自己的研究领域、解决自己遇到的问题。
该系列所有代码下载地址:
最后更多参考精彩博文请看这里:@林夕编程