万字长文 | 手把手教你优化轻量姿态估计模型(算法篇)
作者丨镜子@知乎(已授权)
0.观前提醒在本文中你将会看到:
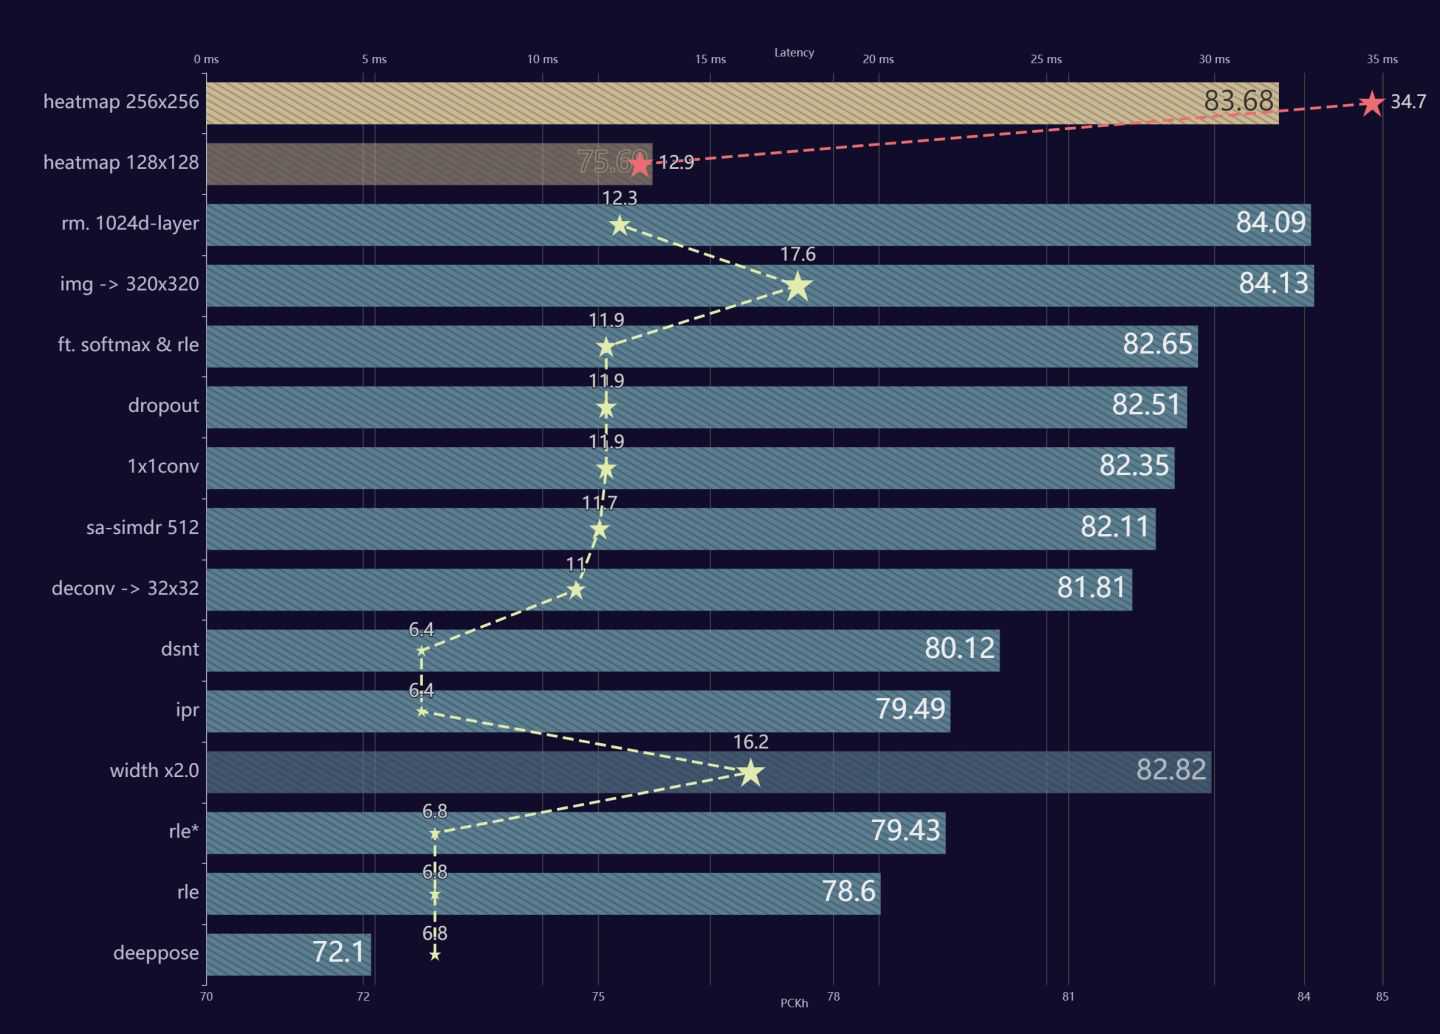
【CPU下12ms】轻量姿态估计模型Regression方法如何做到比Heatmap方法快近3倍且精度更高
【集中盘点】轻量模型常规涨点trick总结
【调参侠秘籍】在无参可调的情况下如何找到可以调的参数
【搬砖心得】项目工程经验分享
【爬坑记录】一些没有起到效果的技术
用充分的实验告诉你,为什么在工程落地中regression方法是比heatmap更好的选择。
1.前言拖了很久的mmpose初体验系列第二期,在上一期中我初步体验了mmpose,牛刀小试之后,接下来就应该真正动手做一些自己的东西了。
mmpose初体验:推理、导出ONNX、转MNN17:
凭借mmpose优秀的实验配置管理系统,我打算建立一组公平的消融实验对比,向大家展示各种方法在轻量模型上的优劣,以及在实际项目优化中我会如何思考和取舍。
在开始动笔时我本来是打算用mmpose跑几个论文验证实验就差不多了,但后面想着干脆要搞就搞个大的,于是最终汇聚成这篇实验报告。严格来说这篇文章已经不算mmpose的学习笔记了,而是基于mmpose做实验的记录,在这个过程中也确实让我对mmpose的运用熟练了很多,在此需要感谢mmpose社区的大佬和小伙伴们的热心解答。
还记得年初ConvNeXt问世时,那张优化路径图给我留下了很深的印象,想着总有一天我也要这么搞一次,于是有了这张图:
本文标题为算法篇,因此写作的核心是围绕算法进行的模型优化,而在真正做项目落地的过程中,优化是全方位的,因此还会有部署篇、数据篇、工程篇等等,以后有机会的话我也会进行总结。
另外本月我将入职openmmlab-mmpose组了,本文中所有涉及的内容,不出意外的话我都会逐一迭代进mmpose开源库中,优化mmpose对轻量模型的支持,敬请期待。
2.Baseline搭建2.1编写配置文件我计划搭建的baseline是shufflenetv2+deeppose方法,目前mmpose的库中暂时没有现成的配置脚本可以用。
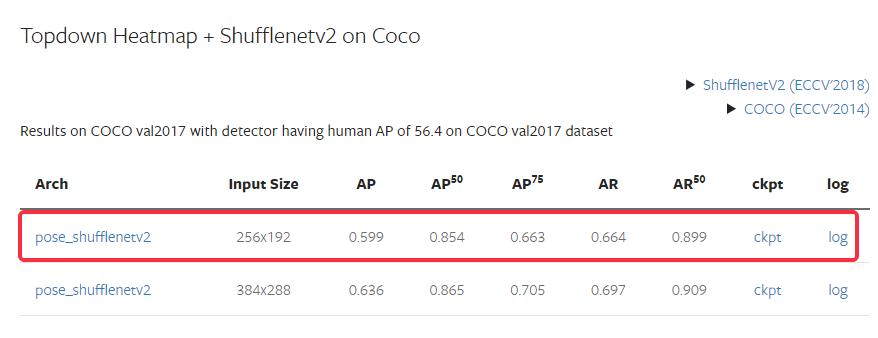
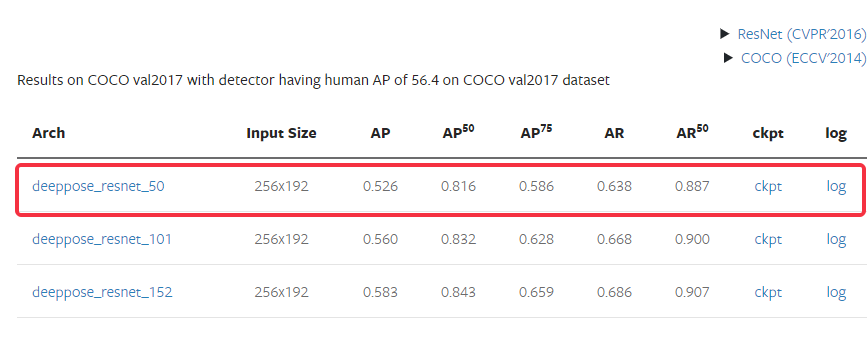
去翻了翻文档里已有的模型记录,虽然当前mmpose并没有轻量模型+回归方法的baseline,但我找到了ResNet50+Regression和ShuffleNetV2+Heatmap在COCO上的两个baseline,所以我很自然地可以参考这两个配置文件来搭建我的目标。
从文档给出的benchmark可以看到,Heatmap方法由于降低了学习难度,在ShuffleNet这样的轻量模型上性能都高于用ResNet50的Regression方法,这也是符合预期的:
接下来开始对比两个config文件:
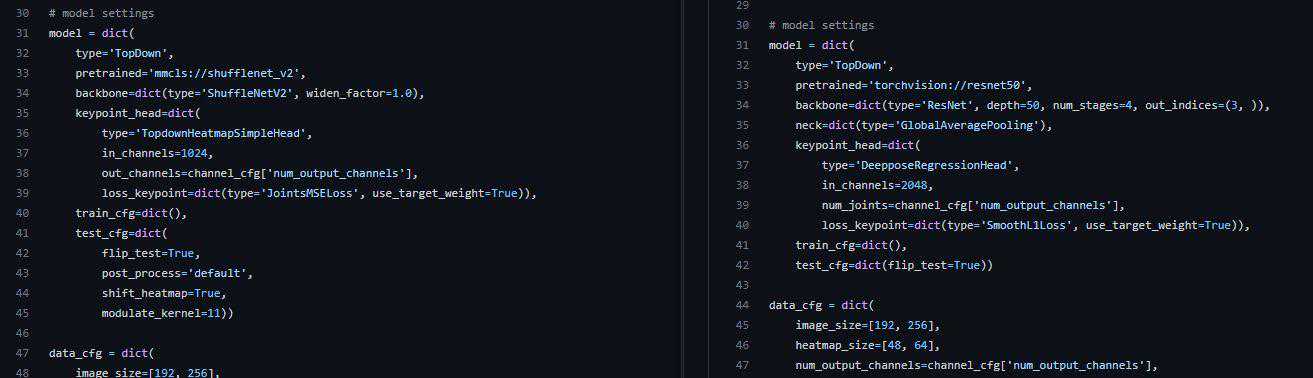
由于两个方法的差异主要体现在模型结构上,其他大部分训练策略都是一样的,在model定义部分分别使用了ShuffleNet和ResNet,可以看到ShuffleNet使用的是基于mmcls的预训练参数,而ResNet50使用的是Torchvision官方的参数。
而决定输出关键点形式的模块keypoint_head一栏,分别用了TopdownHeatmapSimpleHead和DeepposeRegressionHead,对应Heatmap和Regression头部,损失函数上Heatmap方法使用MSELoss,Regression用的SmoothL1Loss。
(弱弱吐槽一句为啥只有这个地方Topdown的D不大写了感觉好别扭,我还专门去查了是不是typo。。)
接下来的data_cfg配置,由于我要在MPII上训练,所以data_cfg和train_pipleline按照res50上mpii的配置即可。
如此,一个ShuffleNetV2+Regression在mpii上的配置文件也可以很快写出来。
同时按照mmpose的命名规则和文件结构存到configs/body/2d_kpt_sview_rgb_img/deeppose/mpii/路径下,命名为shufflenetv2_mpii_256
2.2导出onnx和mnn在完成配置后其实已经可以开始训练了,但是良好的工程习惯是应该先测试模型的导出部署和推理速度,确保这套流程能顺利进行且满足需求后再进行模型的训练。
目前mmpose在设计导出onnx时的脚本并没有考虑到这个需求,是强制要求输入checkpoint进行参数加载的,所以需要对tools/deployment/做一点点的小修改,把强制参数改成可选参数,默认为None
修改为:_argument('--checkpoint',default=None,required=False,help='checkpointfile')然后就可以通过脚本导出onnx文件了:
得到后照例进行一下onnx结构简化:
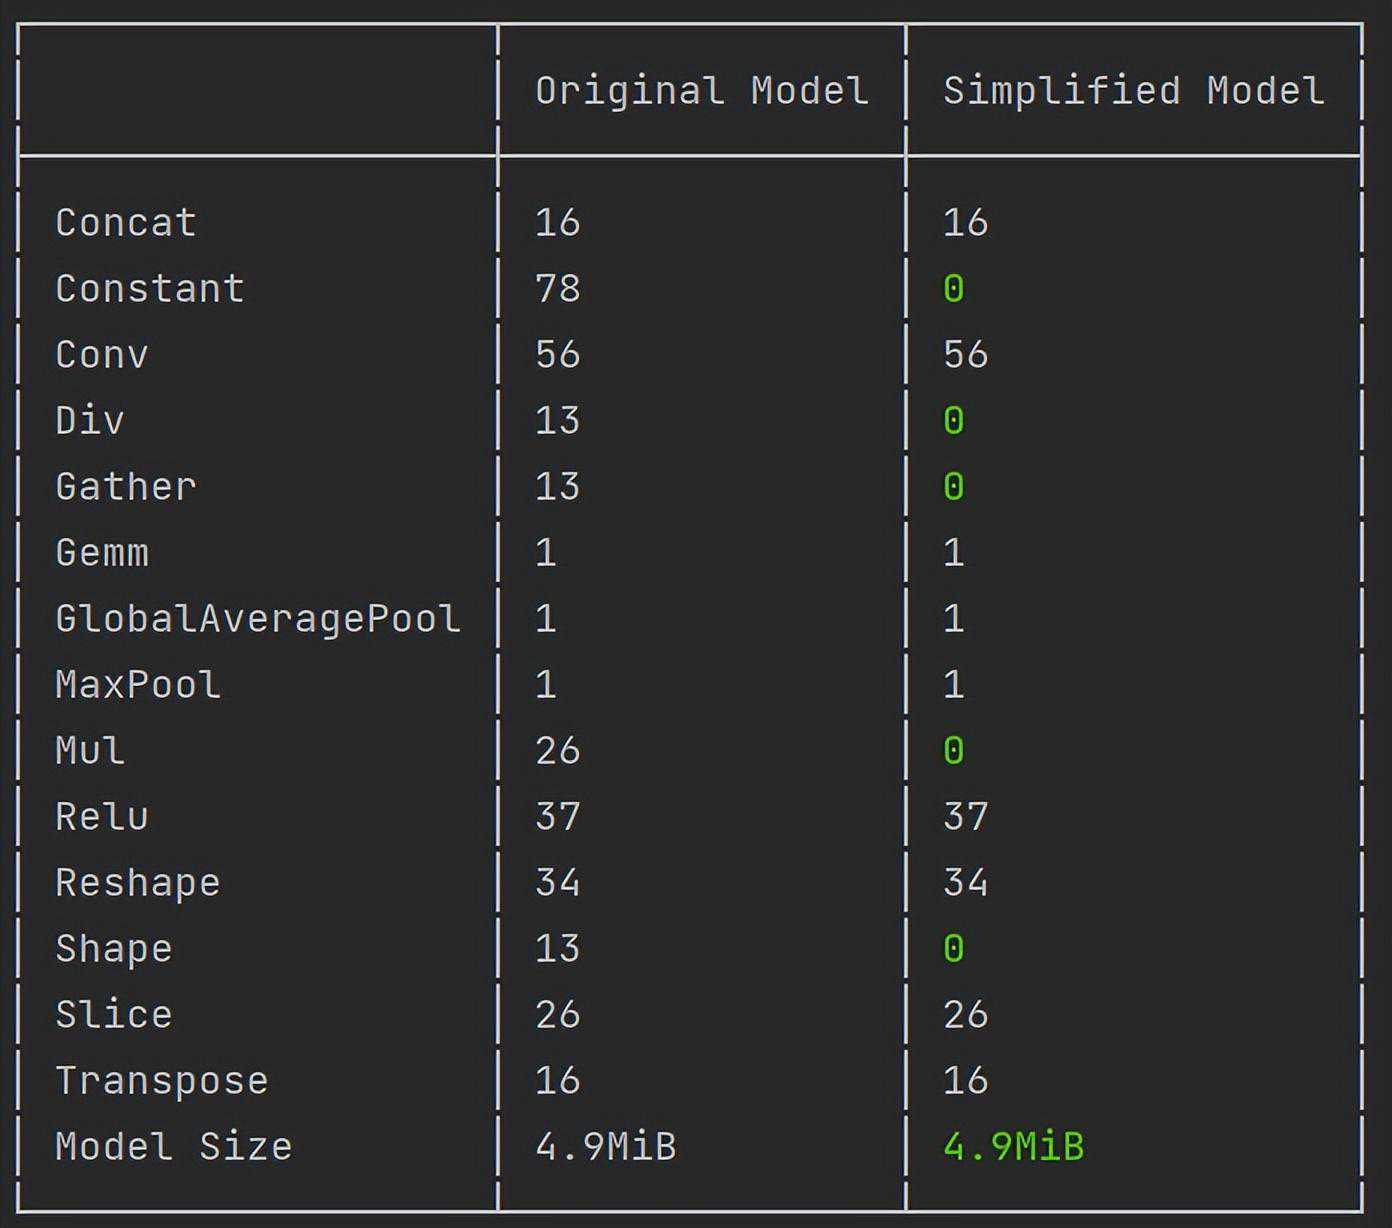
之后也跟上一篇文章一样,把onnx转成MNN:
沿用上一篇文章里实现的python端MNN推理脚本:
importnumpyasnpimportMNNimportcv2importtimeclassPose():def__init__(self,model_path,joint_num=21,mean=[0.485,0.456,0.406],std=[0.229,0.224,0.225]):_path=model__num=joint_=(mean).reshape(1,-1,1,1)=(std).reshape(1,-1,1,1)=(model_path)_sess=({'numThread':1})defpreprocess(self,img):input_shape=(input_shape)==4,'expectshapelike(1,H,W,C)'img=((img,(0,3,1,2))/255.-)/()definference(self,img):input_shape=(input_shape)==4,'expectshapelike(1,C,H,W)'input_tensor=(_sess)tmp_input=(input_shape,_Type_Float,(),_DimensionType_Caffe)input_(tmp_input)(_sess)output_tensor=(_sess)joint_coord=(output_tensor['1022'].getData())returnjoint_coorddefpost_process(self,coords,bbox):w=bbox[2]-bbox[0]h=bbox[3]-bbox[1]target_coords=coords*([w,h])target_coords+=([bbox[0],bbox[1]])returntarget_coordsdefpredict(self,img):img=(img)joint_coord=_process(joint_coord)returnjoint_coordimg=(r'D:\projects\mmpose\tests\data\onehand10k\9.jpg')img=(img,(256,256))inputs=img[None,:]mnn_model=Pose('')forxinrange(5):s=()foriinrange(100):mnn_(inputs)print(f'elapse{(()-s)*10:.4f}ms')测试一下推理速度,在我本地i5-12600KF的cpu上推理是在6ms左右的:
$pythonmnn_
确认了流程没问题后送去训练,为了实验稳定我锁定了随机种子:
在训了几个epoch后我注意到,在每个epoch之间都会有一次UserWarning的输出且有个短暂停顿,根据经验我猜到是因为Dataloader没有开persistent_workers,导致每个epoch都会重新启动多进程,很快我在mmpose/datasets/下找到了Dataloader的定义发现果然如此:
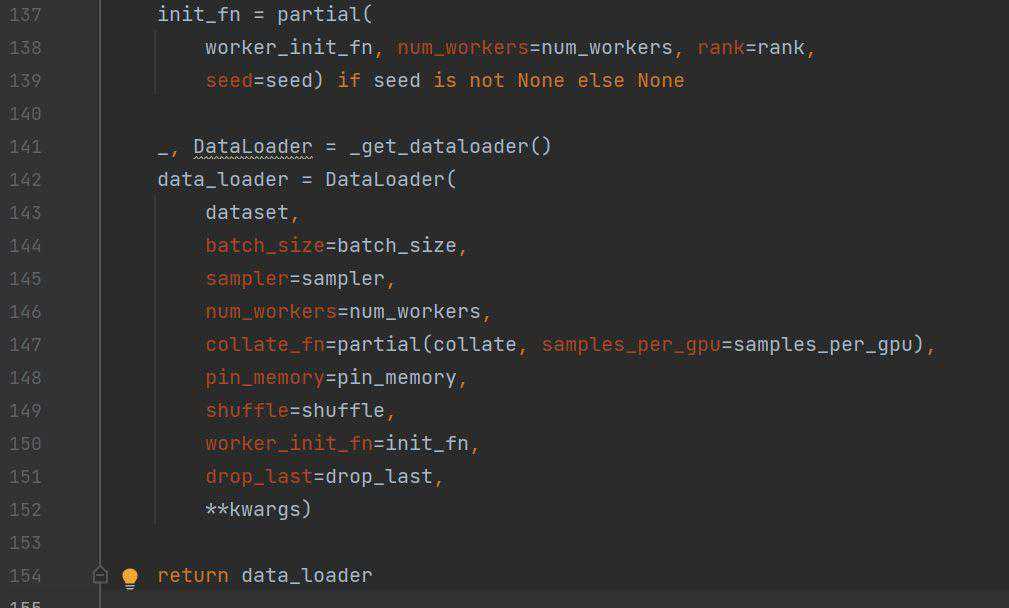
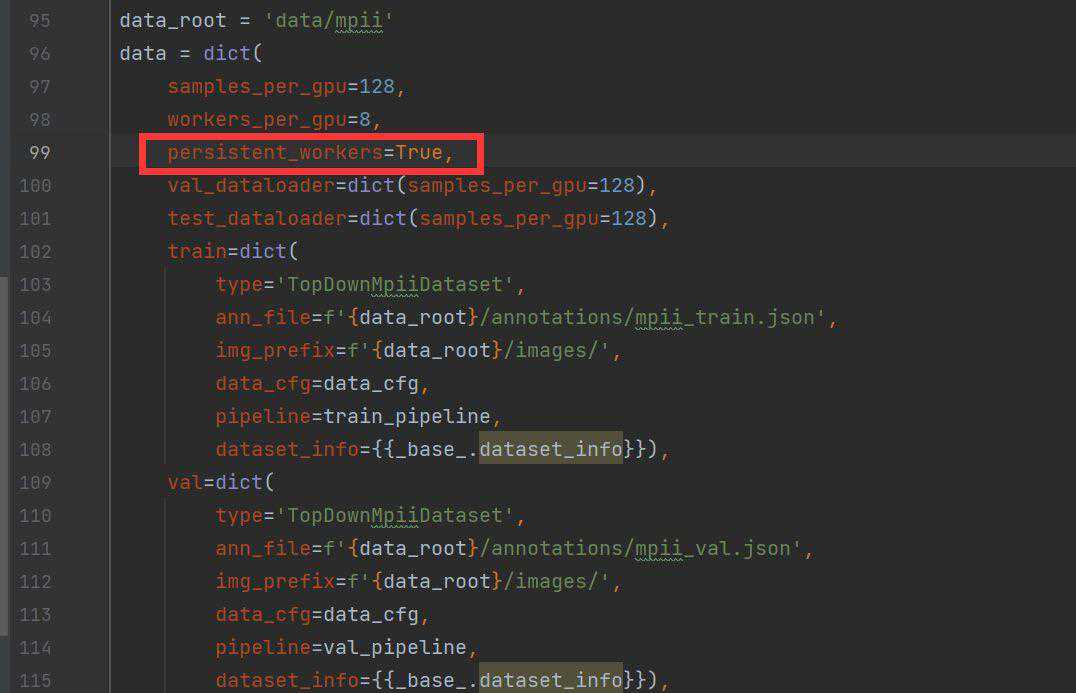
为了加速训练我开启了persistent_workers,由于mmpose优秀的注册器机制,我可以在配置文件中直接手动添加这个参数,而不需要去修改文件:
有了第一个模型的经验后,RLE和Heatmap都是现成的配置文件,如法炮制即可。
为了清晰地横向对比,所以我做了ShuffleNetV2+Heatmap的实验,考虑到Heatmap肯定在精度上有优势,但是存在速度劣势,所以我也导出了Heatmap的MNN模型进行了推理速度测试:
$pythonmnn_
可以发现,Heatmap方法跟Regression方法相比,推理速度慢了接近6倍。而RLE方法由于只是在训练阶段添加了一个flow模型,在推理阶段直接扔掉,所以推理速度跟Regression方法是一样的。
2.4实验小结一在清楚了基本的训练流程后,采用完全相同的实验配置我做了如下四个实验,实验配置为:
单GPU3060Ti
bs=128训练210epoch
adam上学习率5e-4,step=[170,200]
imagenet预训练backbone参数
结果如下表:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
1
deeppose
0.6909
72.1051
10.6661
2
rle
0.7177
78.6000
18.5506
3-1
heatmap256x256
0.8704
83.6872
21.3166
3-2
heatmap128x128
0.7617
75.6987
12.7739
4
rle*
0.7525
79.4353
19.7371
表中带*表示backbone使用了基于heatmap预训练的backbone权重
deeppose:"Head":88.16508,"Shoulder":88.4341,"Elbow":70.78576,"Wrist":56.23045,"Hip":79.0895,"Knee":61.17217,"Ankle":49.71674rle:"Head":81.71896,"Shoulder":92.20448,"Elbow":80.91024,"Wrist":69.95078,"Hip":84.68064,"Knee":70.31898,"Ankle":55.52689heatmap:"Head":94.84993,"Shoulder":92.71399,"Elbow":83.56934,"Wrist":75.99908,"Hip":83.88427,"Knee":77.67446,"Ankle":71.53964rle*:"Head":81.71896,"Shoulder":92.56114,"Elbow":81.72857,"Wrist":71.2035,"Hip":85.14798,"Knee":71.97149,"Ankle":57.0382
从实验结果可以看到,在轻量模型上:
原始的regression方法精度最低
在加入了rle方法后,regression精度得到了一个较大的提升(PCKh上6个点)
不考虑计算效率的话,heatmap方法在轻量模型上效果还是最好的,但是推理耗时是regression的6倍
用heatmap训练后的模型backbone权重训练rle,精度能再进一步提升(PCKh上1个点)
分辨率对于姿态估计任务非常重要,减小输入图片让heatmap方法掉了8个点
另外不得不指出的一点,由于监督方式的不同,梯度形式上的差距使得heatmap在训练效率上是远高于regression方法的,这一点从训练10个epoch的表现就能体现:
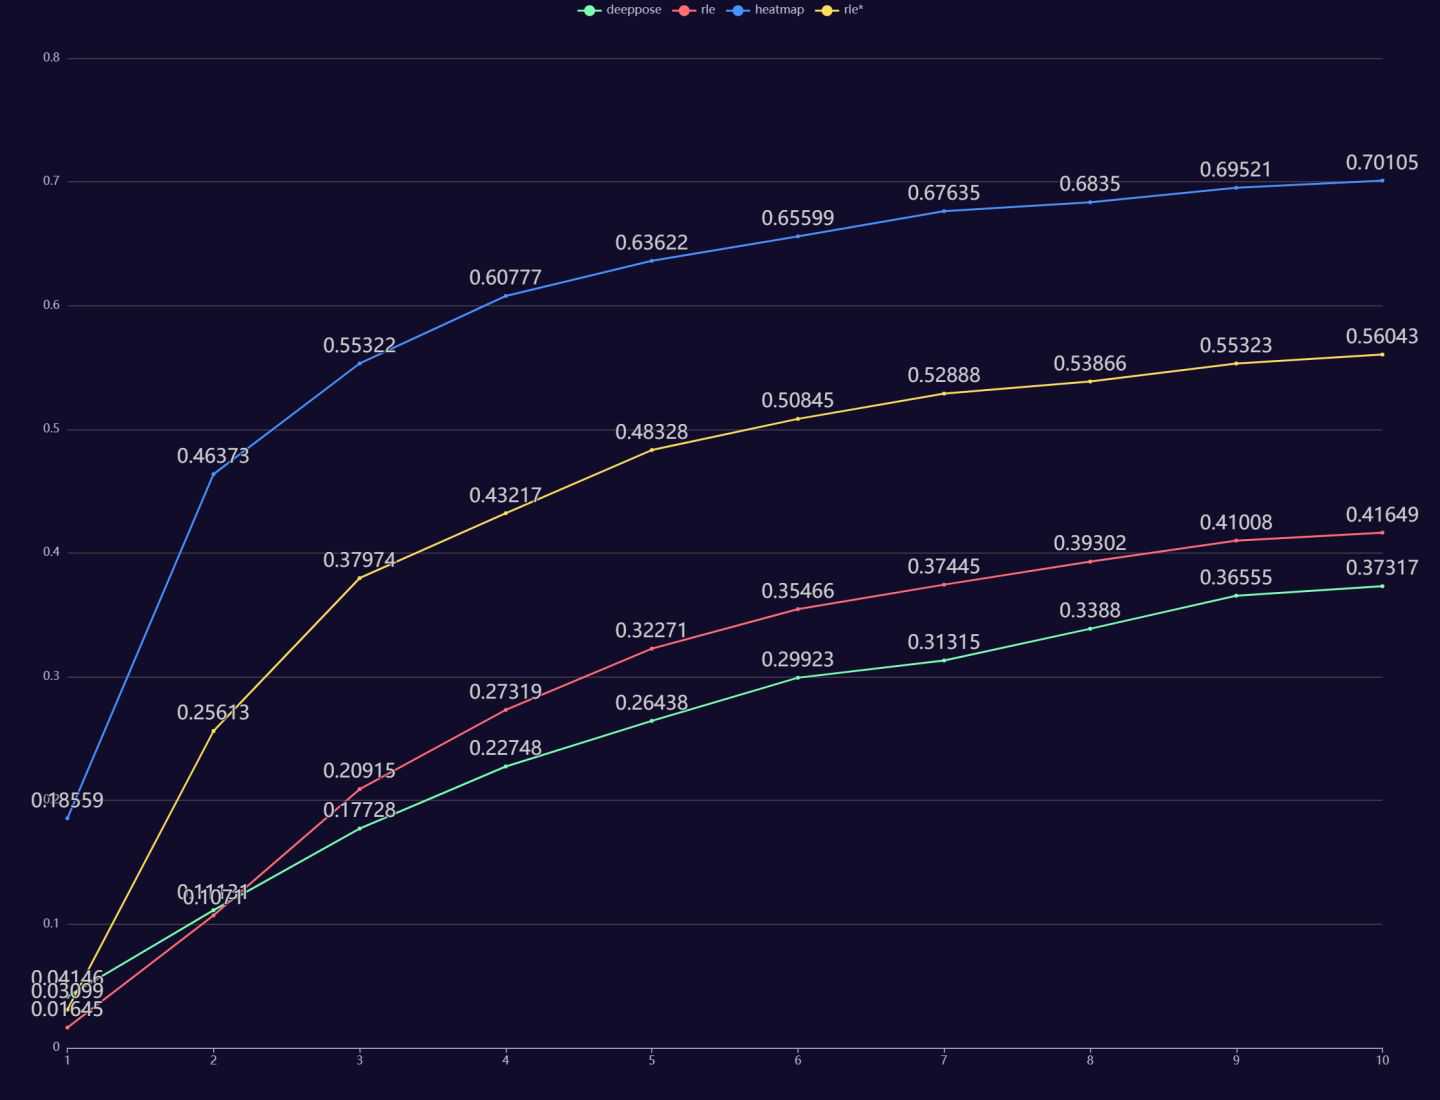
Heatmap方法训练10个epoch后acc_pose能达到0.70
Deeppose方法只有0.37
原始RLE方法训练10个epoch后acc_pose达到0.41
使用预训练权重后RLE方法训练10个epoch的acc_pose达到0.56
考虑到从头训练的rle方法最终acc_pose为0.717,我查询log后发现达到0.70的时间是在100epoch,也就是说在同样使用imagenet预训练的backbone参数情况下,heatmap方法训练10epoch就得到了相当于regression方法100epoch的效果,这就是监督方式不同带来的训练效率差异,而我们要想提升regression方法的性能,其中一个思路就是把更多的监督信息引入到训练中。
3.参数量监督信息到目前为止,有了预训练权重和RLE加持,regression跟heatmap的精度差距是PCKh上4.2个点,而6倍的速度差距给我了充足的算力空间,来进一步提升regression的精度。
此时我有两个思路:
轻量模型之所以弱于大模型,首先是参数量上存在差距。6倍的速度差距让我可以简单粗暴地增大backbone参数量,比如将ShuffleNetV2的宽度系数从1.0变为2.0,推理速度也只是从6ms变成15ms,仍然比heatmap快2倍。
使用IntegralPoseRegression方法,学习隐式的heatmap,有了更多可以引入监督信息的地方。
3.1增大backbone参数量增大backbone最简单的办法就是调整宽度系数,后regression推理速度如下:
最终训练结果如下:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
3
heatmap
0.87041
83.68722
21.31668
5
+rle*
0.78859
82.82332
23.9032
"Head":85.91405,"Shoulder":94.20856,"Elbow":84.42139,"Wrist":75.15977,"Hip":87.06935,"Knee":77.39249,"Ankle":64.12375,"PCKh":82.82332,"PCKh@0.1":23.9032
可以看到,跟heatmap版本的差距已经非常小了,PCKh上只相差0.8个点,PCKh@0.1超越了2.6个点,而推理速度比heatmap快2倍。加入我继续加大backbone的缩放比例到2.5或者3.0,应该是可以全面追平和超越heatmap的,但这样并不是一个好的优化思路,由于低算力设备的cpu通常是远弱于台式机的,经常会出现慢2-3倍的情况,因此15ms差不多是本地测试可以接受的最低速度了,这样一来backbone直接占用了大部分算力,模型头部就没有任何可以优化的空间了。而实际在优化时,backbone的优化通常是放在最后进行的。
这个实验的目的也主要是想告诉大家,推理速度的优势意味着可以增加更多的参数量,这对于轻量模型而言至关重要。
3.2IntegralPoseRegressionIntegralPoseRegression方法由来已久,最早提出是为了解决Heatmap方法argmax操作不可微分的问题,通过对网络输出的heatmap计算softmax后求期望的形式得到坐标值。
对于这种方法我过去写过很多篇文章来介绍基础和优化,大家可以自行前往我的历史文章阅读,不在这里赘述了。
由于IntegralPoseRegression方法是基于坐标值进行监督,因此我选择在deeppose方法head上进行修改,在/mmpose/models/heads/下复制deeppose_regression_创建了一个integral_pose_regression_,创建IntegralPoseRegressionHead类,并在__init__.py中进行添加,与此同时我还保留了RLE使用的接口。
核心代码大致如下:
@_module()classIntegralPoseRegressionHead():def__init__(self,in_channels,num_joints,feat_size,loss_keypoint=None,out_sigma=False,train_cfg=None,test_cfg=None):super().__init__()_channels=in__joints=num_=build_loss(loss_keypoint)_cfg={}iftrain_cfgisNoneelsetrain__cfg={}iftest_cfgisNoneelsetest__sigma=out_=build_conv_layer(dict(type='Conv2d'),in_channels=in_channels,out_channels=num_joints,kernel_size=1,stride=1,padding=0)=feat_=(0.0,1.0*,1).view([1,]).repeat([,1])/=(0.0,1.0*,1).view([,1]).repeat([1,])/=(,requires_grad=False)=(,requires_grad=False)ifout_sigma:=((1,1))=(_channels,_joints*2)defforward(self,x):"""Forwardfunction."""ifisinstance(x,(list,tuple)):assertlen(x)==1,('DeepPoseRegressionHeadonlysupports''single-levelfeature.')x=x[0]featmap=(x)s=list(())featmap=([s[0],s[1],s[2]*s[3]])featmap=(featmap,dim=2)featmap=([s[0],s[1],s[2],s[3]])scoremap_x=()scoremap_x=scoremap_([s[0],s[1],s[2]*s[3]])soft_argmax_x=(scoremap_x,dim=2,keepdim=True)scoremap_y=()scoremap_y=scoremap_([s[0],s[1],s[2]*s[3]])soft_argmax_y=(scoremap_y,dim=2,keepdim=True)output=([soft_argmax_x,soft_argmax_y],dim=-1)_sigma:x=(x).reshape((0),-1)pred_sigma=(x)pred_sigma=pred_(pred_(0),_joints,2)output=([output,pred_sigma],dim=-1)returnoutputIntegralPoseRegression方法由于是在backbone输出的8x8特征图上进行的soft-argmax操作,因此对推理速度的影响很小,跟纯regression方案基本一致(甚至快了0.4ms):
3.3DSNT:为IPR分布添加正则约束最原始的IntegralPoseRegression方法,即soft-argmax,在这里性能上并没有明显的优势,但却给了我们加入更多监督信息的机会。
相比于deeppose直接回归出坐标值,我们可以在IPR的分布表征上对分布进行监督,这也就是2018年提出的DSNT方法,我实现了一个DSNTLoss,即在Loss中加入了对分布的正则化约束。
方便起见,我直接用了DSNT论文作者开源的dsntnn库中提供的js_reg_losses,小伙伴们可以通过pipinstalldsntnn获取
不过dsntnn库中的坐标归一化是[-0.5,0.5],而mmpose使用的是[0,1],需要手动修改一下dsntnn库中的normalized_linspace方法:
first=-()/length这里权重可以调参returnloss
加入DSNT后,我们的模型开始有了可以调参的地方(调参侠狂喜),这里有两个:一是渲染的高斯分布方差sigma取值,二是dsnt跟rle相加的loss权重。
另外此处模型需要同时优化两个loss,而目前mmpose只支持单个loss的优化,所以写成这样,经过跟亦宁大佬沟通,预计在下半年mmpose会加入对多loss的支持,并且会采用更优雅的方式实现。
3.3实验小结二实验序号
方法
acc_pose
PCKh
PCKh@0.1
6
ipr
0.7235
72.5787
11.4572
7
ipr+rle*
0.8104
79.4925
18.9773
8
dsnt+rle*
0.8208
80.1275
19.2844
通过结果可以看到,单独使用integralposeregression方法相较于deeppose,能在推理速度不变的情况下带来性能提升。但这还远远不是ipr方法的全部实力,ipr优秀的表征能力配合rle提供的更优质的监督信息,让regression-based方法训练效率大大提升,训练10个epoch的acc_pose达到0.70,媲美heatmap:
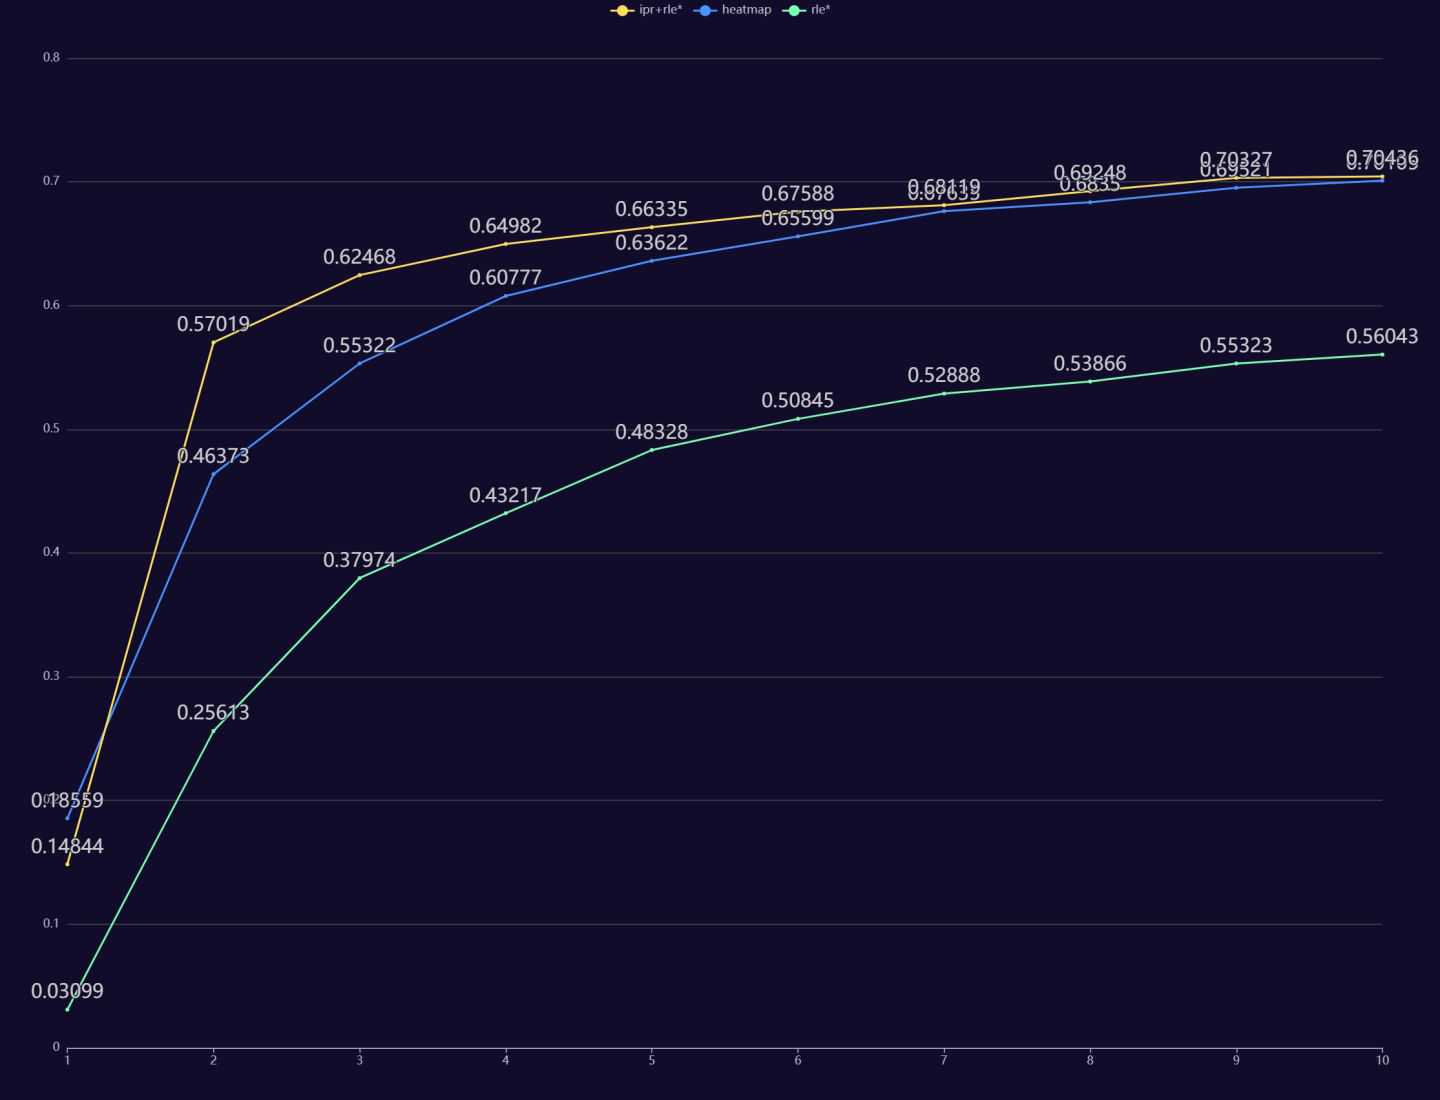
而这里我需要指出的是,ipr的梯度形式相比于heatmap监督仍然是更差的,这里的暂时追平是rle和pretrained共同作用的结果,在后续的训练中ipr由于分布形状不明确、梯度不稳定等因素,收敛速度会有一个明显的停滞,从结果也可以看到,除了初期收敛快以外,最终的性能并不比加了rle的deeppose高多少(PCKh上0.19个点)。
关于梯度影响训练效率的差异的具体分析,我之前写过一篇笔记一文总结IntegralPoseRegression方法的方方面面
DSNT的调参方面:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
8-1
w=1,sigma=2.0
0.8044
79.0710
18.5844
8-2
w=1,sigma=1.0
0.8073
79.1413
18.5297
8-3
w=1,sigma=0.5
0.8117
79.2532
18.9591
8-4
w=1,sigma=0.25
0.8145
79.7268
19.3677
8-5
w=1,sigma=0.125
0.8152
79.7267
19.1465
8-6
w=10,sigma=0.25
0.8208
80.1275
19.2844
8-7
w=100,sigma=0.25
0.8260
79.9089
18.3685
一开始设置的最常用的sigma=1.0和2.0都有不同程度的掉点,从sampling-argmax论文中也提到,这种强行加约束的方式有时是会导致掉点的,毕竟你很难知道当前的分布尺度最适合的sigma是多少。而dsnt论文实验这张图也显示,特征图分辨率7x7时加约束反而是不如无约束的:
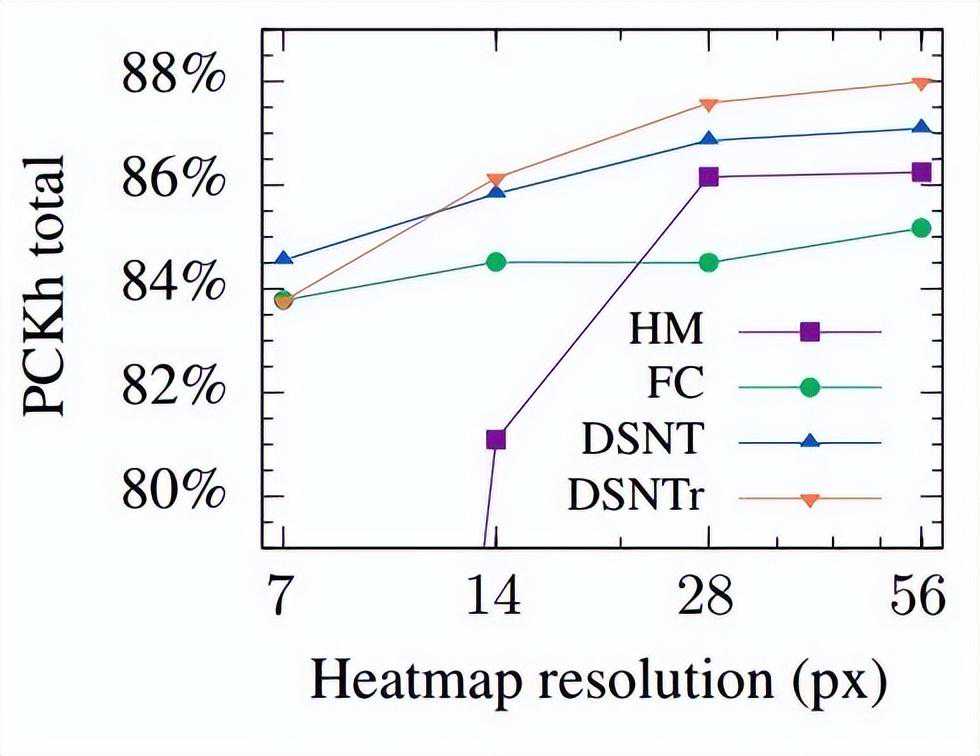
但是后来我考虑到人体姿态估计常用的heatmap尺寸是64x64,最佳sigma=2,dsnt中用的28x28可以近似看成32x32,最佳sigma=1,那么8x8下适用的sigma应该等比例缩小到0.25或者0.125,跑了一下实验果然在0.25和0.125上有了涨点。这样来看dsnt作者的炼丹技术还有待加强(笑)。
再对dsnt的正则化loss权重进行了简单的调参,最终相较于纯ipr有PCKh上0.6个点的提升。w=100时虽然训练阶段pose_acc上升了,但val的PCKh和PCKh@0.1都掉点了,这说明出现了过拟合,因此最终我选定w=10,sigma=0.25这组参数。
由于我本人不是一个调参爱好者,比起调参还是更倾向于从原理上优化,而且用自己的本地机器调参实在太慢也太蠢了(电费顶不住了),这里就不继续了,从dsnt的论文来看,特征图分辨率从7x7提升到28x28有接近3个点的提升,这给我们指明了新道路:增大特征图分辨率。
4.特征分辨率表征形式4.1增大特征图分辨率特征分辨率对于视觉下游任务的重要性,从HRNet之后几乎也是一个共识了,所以这个思路并不难想到。
如果将模型输出的heatmap看成一个二维的离散概率分布,那么这个heatmap的分辨率无疑是与精度高度相关的。
如dsnt实验中,把分辨率从7x7提升到28x28就能有3个点的提升(resnet上),那么在推理速度可以接受的范围内,这无疑是一种提升性能的有效手段。
我效仿SimpleBaseline在骨干网络输出的特征图后面接了转置卷积层用于上采样,在我原本代码的基础上只需要把改成堆叠的转置卷积即可。
考虑到推理速度,我没有像SimpleBaseline那样用三层通道数为256的deconv,后接一个1x1卷积把通道数合并到关键点个数。而是只用了两层deconv,第一层256通道,第二层直接压缩到关键点个数。
SimpleBaseline:deconv=[256,256,256]conv=Conv2d(256,16,k=1)我的做法:deconv=[256,16]
这里关于计算量和性能的trade-off非常主观,没有太多依据可言,我的做法并不是最优的。
4.2SimDR在SimDR论文中用实验证明,关键点表征并不需要全程维护二维的heatmap,用一维来表征也是足够的。
这个其实很好理解,毕竟IPR方法最后也是分别对heatmap在x和y轴方向求和得到各自的一维表征,既然这都行得通,那么模型直接预测一维向量表征是相当符合直觉的。
根据SimDR论文实验结果显示,使用原图两倍长度以上的一维向量就能取得不亚于二维heatmap的精度:
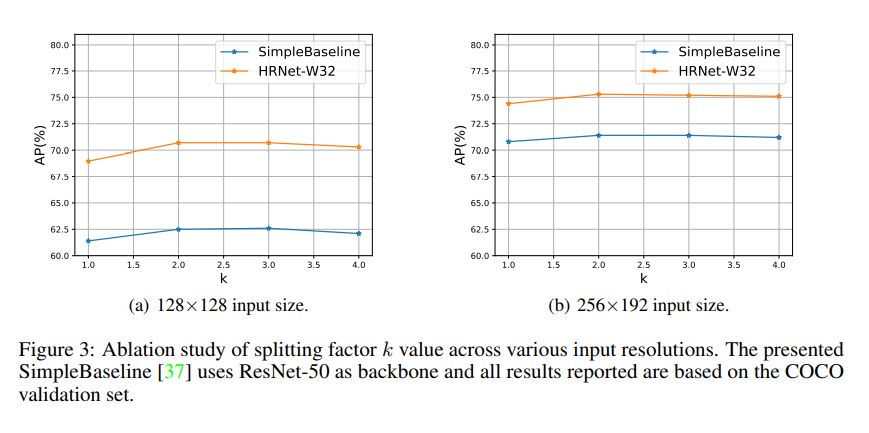
另外我觉得这个结果可以用香农采样定理来解释,至少要用2倍的表征长度(采样频率),才能无损地恢复原尺寸的离散分布。当然,这只是我开的一个脑洞,并不严谨。
遵循SimDR的做法,将经过两次上采样得到32x32的特征图拉直得到长度为1024的一维特征,对这个特征进行线性映射到我们想要的任意长度,然后平均拆分成两段,作为x和y坐标的特征。
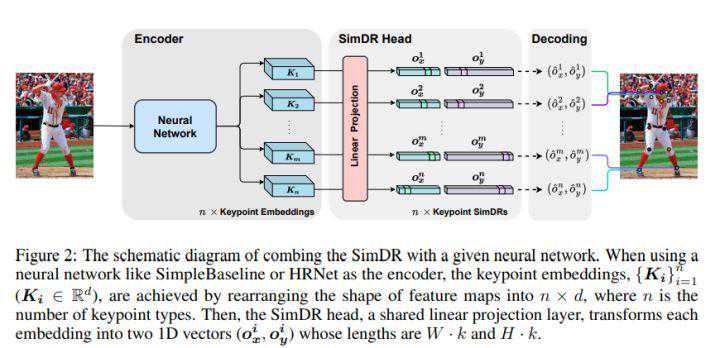
跟论文不同之处在于,原文是按照heatmap方法进行后处理,即对一维特征进行argmax获取坐标,而我是用IPR的方式用soft-argmax进行解码,从而保持端到端的训练。
为了验证方法的有效性,对比实验是免不了的,首先实验简单提升分辨率后用32x32的heatmap表征的dsnt方法精度,后续做法跟上面一样,对heatmap做softmax归一化然后求期望,最终模型的推理速度为:
32
使用SimDR则是对两个512长度的一维特征分别进行softmax归一化,后续做法跟dsnt类似,只不过dsnt监督的高斯分布是二维heatmap,而SimDR是在一维上监督,因此loss和target实现上有区别,但背后的原理是一样的。SimDR的推理速度为:
原始版本的SimDR是使用one-hot作为target,用交叉熵进行监督的,这样的做法是完全将定位问题当成分类问题来处理,这样做虽然可以,但还有提升的空间,即像heatmap方法一样用高斯分布作为target,用KL散度来监督。采用了高斯分布监督的SimDR方法在论文中称为SA-SimDR,论文实验中SA-SimDR在COCO上性能超过了Heatmap方法。
关于这部分我也写过一篇为什么说Heatmap方法是分类问题?来分析原因。
4.3实验小结三实验序号
方法
acc_pose
PCKh
PCKh@0.1
9
dsnt+deconv+rle*
0.8710
81.8111
20.6219
10-1
simdr+rle*
0.8783
81.5326
20.1353
10-2
sa-simdr(sigma=4)+rle*
0.8869
81.8241
20.4449
10-3
sa-simdr(sigma=6)+rle*
0.8904
82.1155
20.5672
11
sa-simdr(sigma=6)+1x1conv+rle*
0.8753
82.3549
20.9342
单纯的SimDR如果不加高斯分布监督,取得的结果跟加了dsnt的大分辨率结果比掉了大概0.3个点。
这里就又涉及到需要调参,sigma的选择,由于当前的一维表征长度为512,我按照之前的经验先取到sigma=4,PCKh有0.3个点的提升,基本追平了之前的dsnt方法。
随后我查阅了SimDR源代码发现作者使用的是sigma=6,实验后取得了82.115的PCKh,此时已经超越了dsnt方法。
由于我一开始选用的上采样策略非常激进,后面我在deconv后补了一个1x1卷积。可以看到这层1x1卷积能带来0.2个点的提升。
5.公式调参CoordConvDropout实验进行到这里,似乎能调的参数都已经调的差不多了,但是我们的模型距离heatmap方法还有2.5个点的差距,怎么办呢?在这里我分享一点调参侠独门秘籍,从已有的方法原理里找可以调的参数。
5.1Softmax首先是Softmax这个函数,大家应该都不陌生,完整的公式为:
这里的smooth系数
常常被省略,但实际上它是一个调整softmax平滑程度的系数。当输入的响应值过小时,Softmax的结果往往过于平滑,这会导致Soft-Argmax的结果趋近于分布的中央,不能正确地得到最大值位置,所以就需要通过来增大输入值,使得Softmax的输入保持在一个合适的精度范围。
但事实上,增大smooth系数来提升softmax近似程度并不好,这会导致梯度消失,后来我读到了王峰大佬的博文《Softmax理解之Smooth程度控制》给出了一个更合理的优化方案:
王峰:Softmax理解之Smooth程度控制
在人脸识别任务中,网络的最后一层线性变换分类层,实际上可以看成是把前一层输出的特征,与最后一层的权重在计算内积。如果把特征和权重都进行归一化,那么最后一层的物理含义就变成了计算余弦相似度,取值范围就限定在了[-1,1],所以特征图的响应值范围就限定下来了,接下来再乘上一个尺度因子s来拉大响应幅度,就可以很容易地保证输入到Softmax里的分数能在一个合适的范围:
如此一来,就能使得网络的响应值始终控制在Softmax拟合程度好的范围,减小Softmax自身性质引入的计算误差。
而实现这一点也很简单,只需要增加两个全连接层:
feat_x,feat_y=(pred_simdr,2,dim=-1)mlp_x_norm=(_,dim=-1)norm_x=(feat_x,dim=-1,keepdim=True)feat_x=_x(feat_x)feat_x/=norm_xfeat_x/=mlp_x_(1,1,-1)feat_x*=_y_norm=(_,dim=-1)norm_y=(feat_y,dim=-1,keepdim=True)feat_y=_y(feat_y)feat_y/=norm_yfeat_y/=mlp_y_(1,1,-1)feat_y*=
此处的beta作为缩放系数,是可以进行调参的,由于过大的beta会导致梯度消失,我写了一个简单的脚本来估计合适的缩放范围:
defsoft_argmax(idx,value,length):size=length在第8项上设置响应target_idx=idxa[target_idx]=value进行softmax归一化softmax_res=(0)求期望值lin=([xforxinrange(size)])expectation=(lin*softmax_res).sum()#print('expectation:\n',expectation)returnexpectationforxin[1,10,11,12,13,14,15,16,20,30,32,40,50,100,256,512]:length=512err=0.foridxinrange(length):expect=soft_argmax(idx,x,length)err+=(idx-expect)**2print(x,err)1tensor(11110072.)10tensor(5772.4692)11tensor(804.1144)12tensor(110.0054)13tensor(14.9522)14tensor(2.0244)15tensor(0.2741)16tensor(0.0369)20tensor(1.3588e-05)30tensor(1.4985e-16)32tensor(2.7446e-18)40tensor(3.0886e-25)50tensor(6.3661e-34)100tensor(0.)256tensor(0.)512tensor(0.)这个脚本统计了不同长度的表征时,不同响应值带来的误差,取到15左右时soft-argmax的误差在1以内,因此我选择了15作为beta。按理来说随着模型训练进行,beta可以逐渐增大来使得预测更加准确,但我没有进行尝试了。
5.2RLE关于RLE其实有一个不太多人知道的小趣事,indigo和亦宁大佬在向mmpose添加RLE方法的过程中,发现作者开源的RLE代码跟论文公式有一点小出入,logQ中多加了一个log(sigma)。
RLE公式如下:
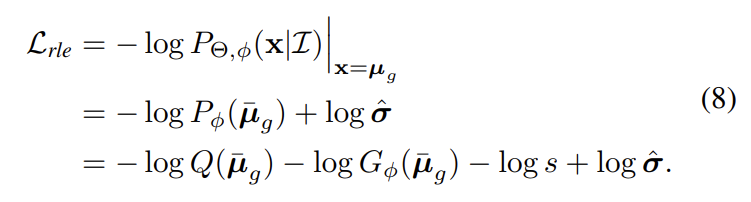
代码实现:
_dis=='laplace':loss_q=(sigma*2)+(error)else:loss_q=(sigma*(2*))+0.5*error**2
这一项的引入可能是由于疏忽,因为按照原文的定义,Q应该是一个标准分布,因此sigma为1,跟模型预测的out_sigma是不同的。但是在去掉这个log(sigma)后模型出现了掉点,因此大家最终决定保留了这一项。
那么这多出来的log(sigma)为什么会起作用呢?
我个人目前觉得可以从多任务学习的角度来理解,多出来的这一项可以看成一个aux_loss,让模型在优化RLE的同时,也需要优化另一个辅助任务,而这个辅助任务的目标是尽量缩小sigma。
在RLE方法中,模型预测的sigma是完全自适应优化的,用来反映模型预测的不确定度,尽管损失函数本身就会倾向于让sigma缩小,但既然增加这一项能涨点,这就说明模型原本对sigma缩小这个目标的权重还不够。
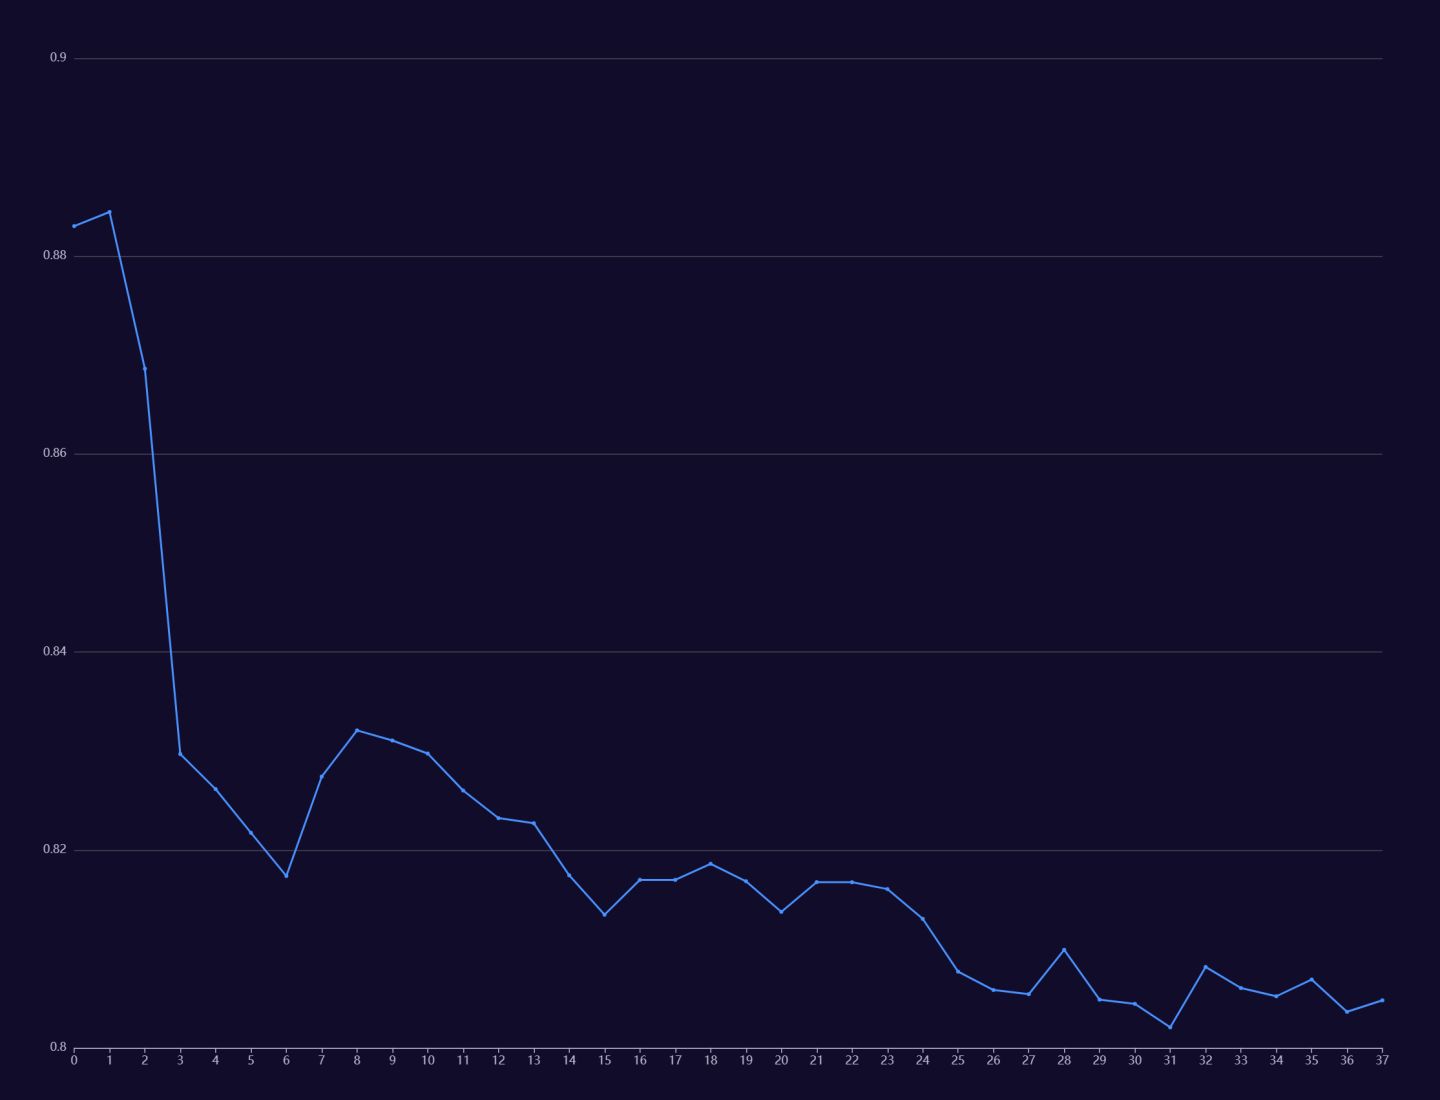
在RLE论文中,作者提出可以用sigma来计算预测的置信度:
于是我输出了随着训练进行用sigma预测关键点存在性的准确率,结果是默认情况下随着训练的进行,sigma预测的准确率在降低,这说明自适应优化的sigma并没有很好地减小,甚至在增大。
所以到了这里,我们就可以很自然地给这多出来的log(sigma)加上一个权重进行调参了(调参侠再次狂喜)
_dis=='laplace':loss_q=gamma*(sigma*2)+(error)else:loss_q=gamma*(sigma*(2*))+0.5*error**2
增大了log(sigma)权重后,sigma预测的准确率停止了下降,不过出现一个现象:权重不论取多大,每一轮的准确率变化都一模一样:
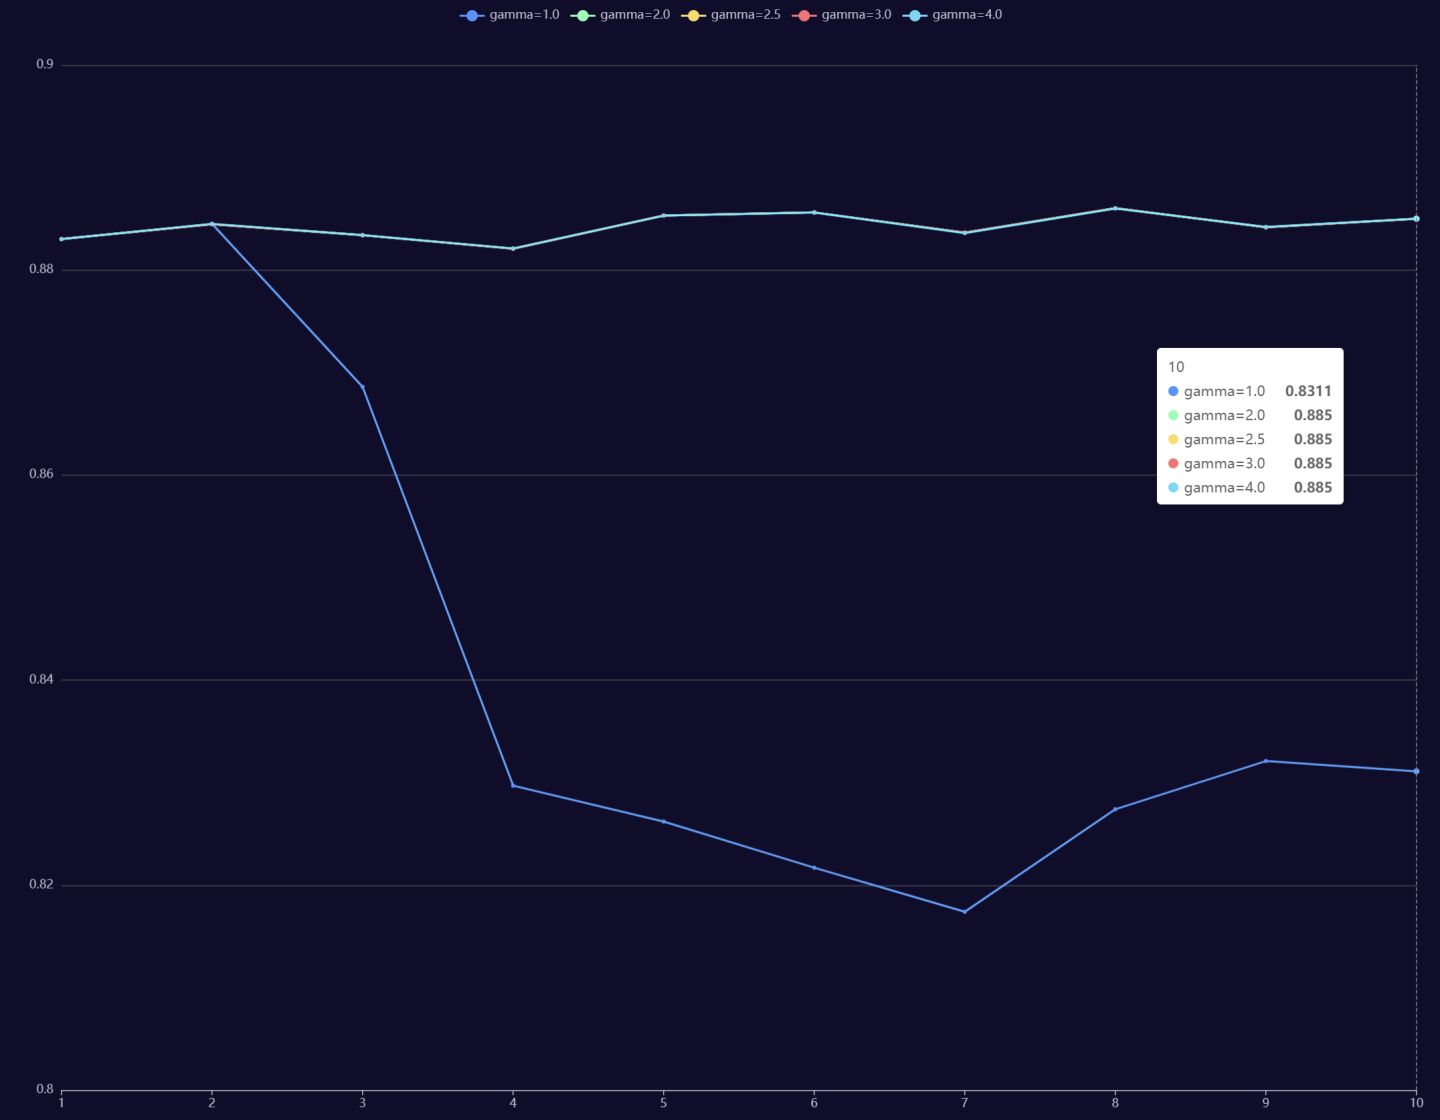
我推测这个现象出现的原因是加大权重后,使得模型倾向于一直缩小sigma,因此把所有点都预测为存在了,毕竟目前没有监督信息。
这里的调参我小偷了一下懒,没有再跑满210epoch,而是根据10个epoch后的PCKh来选择(电费真顶不住了)。
实验序号
方法
PCKh
12-1
1.0
79.1855
12-2
2.0
79.3911
12-3
2.5
79.7840
12-4
3.0
79.5446
12-5
4.0
79.7424
12-6
5.0
79.6877
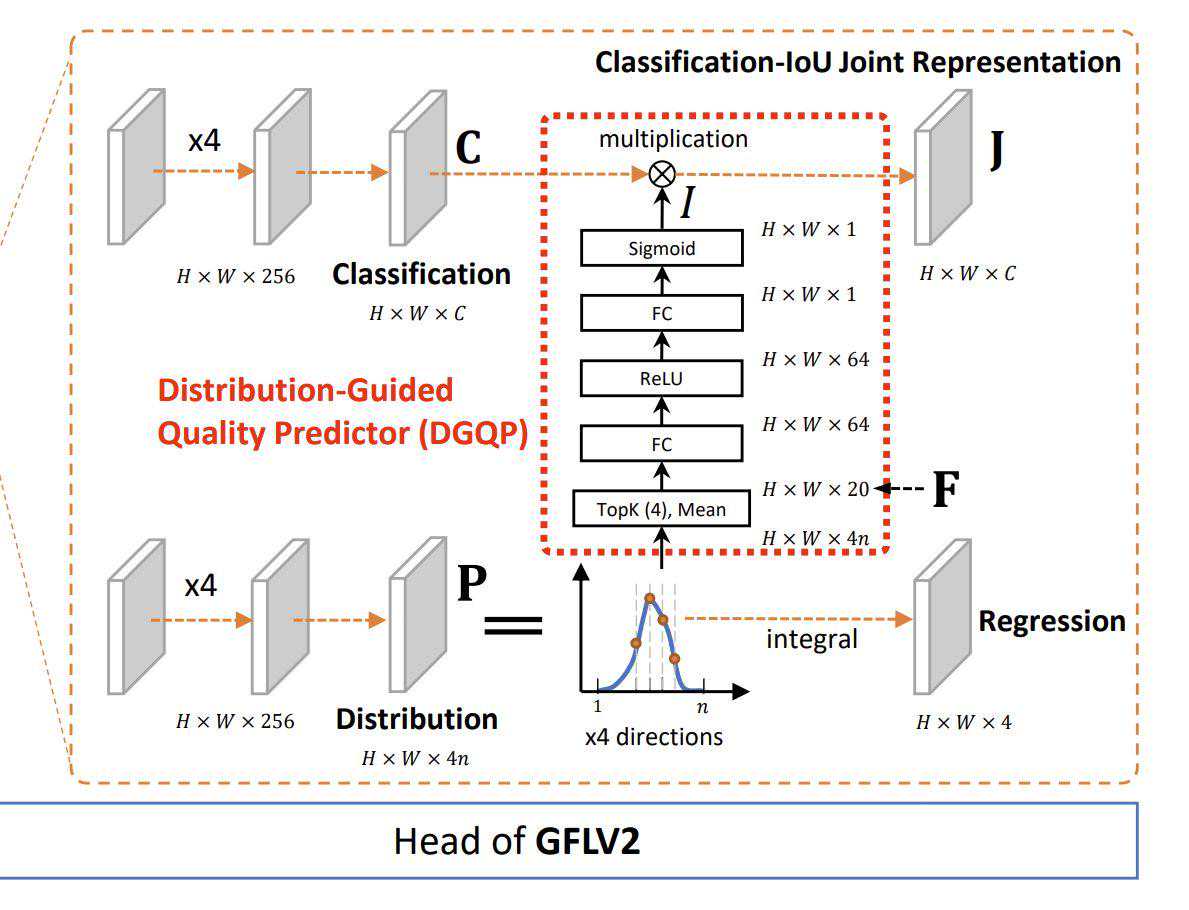
5.3GFLv1v2既然观察到了sigma变化趋势,很自然地会想到给sigma加一个监督,就用target_weight信息即可,因为当关键点存在时我们会希望sigma小,反之希望sigma越大越好。
这里我先实验了最简单的binarycrossentropy,随后将bceloss换成了GFLv1中提出的QualityFocalLoss,最后再添加了GFLv2中提出的轻量头部,用坐标表征的统计值学习一个权重,乘到sigma预测的分支上。
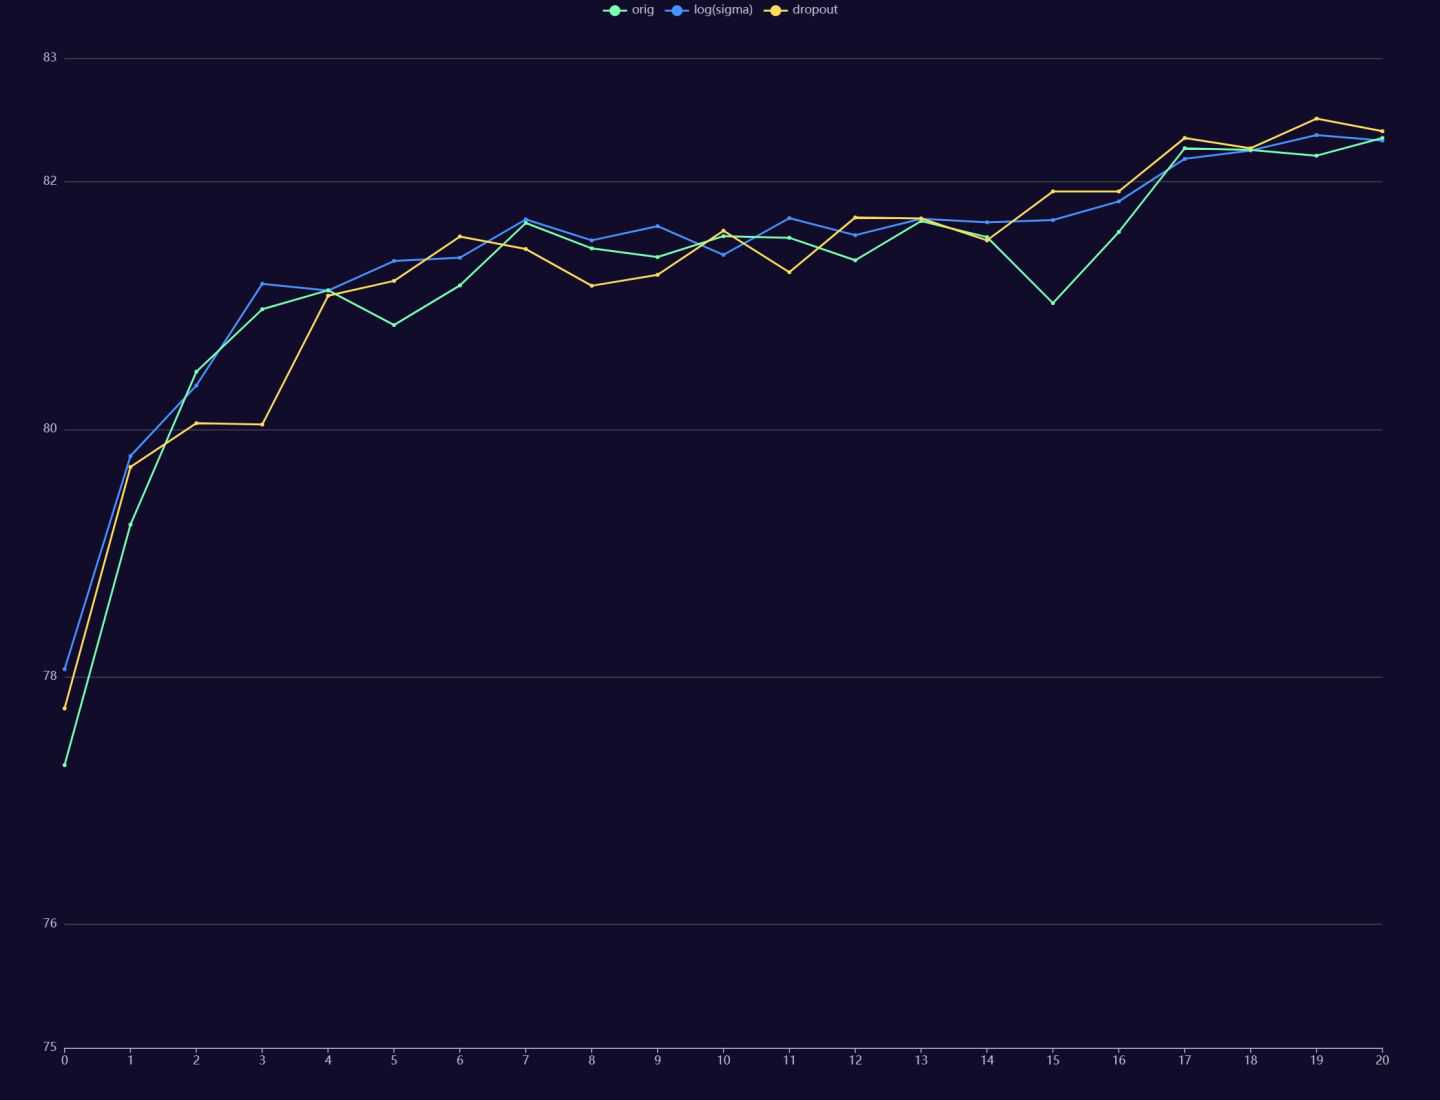
在前面的实验中我们可以发现,大量全连接层的应用已经使得模型出现了比较严重的过拟合,验证集上82的时候训练集指标已经89了,因此引入一些正则化手段是有必要的,这里我用了Dropout,这是我们刚开始接触深度学习几乎都会学到的一个技术。
5.5实验小结四实验序号
方法
acc_pose
PCKh
PCKh@0.1
sigmaacc
13
+softmax-basednorm
0.8750
82.2456
21.2959
0.8240
14-1
+log(sigma),gamma=2.5
0.8802
82.3784
20.9238
0.8841
14-2
+softmax-basednorm+log(sigma),gamma=2.5
0.8802
82.3237
21.4468
0.8848
15
+bceloss+softmax-basednorm
0.8705
82.2248
21.1501
0.9713
16-1
+qfl+softmax-basednorm
0.8535
82.1650
21.3921
0.9766
16-2
+DGQP+qfl+softmax-basednorm
0.8570
81.6185
21.3167
0.9833
17-1
+dropout(0.2)+log(sigma),gamma=2.5
0.8651
82.5111
21.0252
0.8829
17-2
+dropout(0.2)+softmax-basednorm+log(sigma),gamma=2.5
0.8753
82.6568
21.2204
0.8868
从结果来看:
基于softmax的优化对于PCKh@0.1的提升比较明显。
为log(sigma)加权主要是提升了模型初期的收敛速度,且使模型训练更加稳定,但对最终提点没有太大的帮助。
对sigma加监督信息后可以提升存在性预测的准确率,但是会干扰定位任务的学习。
加dropout能有效减轻过拟合,并能带来0.2个点的提升。
采用QFL比BCE对存在性预测的效果更好,但也更加影响定位任务的学习
DGQP可以进一步强化QFL的效果,但对定位任务的影响更加严重,也许可以通过加长训练周期来解决
目前模型的推理速度为11.7ms:
6.图片分辨率抑制过拟合6.1增大图片分辨率提升输入图片的分辨率同样是一个常见的手段了,但我选择放到最后来使用,因为这种方式增加的计算量是巨大的,很容易挤占别的方法的优化空间。得益于我前面的“勤俭节约”,目前模型还有一些算力空间可以给我挥霍,我选择了在这里祭出这个万金油操作。
由于图片分辨率增加带来的计算量提升是影响整个模型的,我实验了输入320x320,推理时间为:
结果如下:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
18
320x320,with1024d
0.8822
84.1374
24.2571
6.2抑制过拟合到了这一步,我们的一开始的精度目标已经达成了,regression方法用17ms的推理速度达到了比heatmap更高的精度,但是前面我也提到,在本地测试一般我会以15ms作为接受的底线,于是需要考虑如何在不尽量损失精度的情况下把速度优化下来。
首先我减去了一层deconv层,只留下一层deconv进行上采样后接1x1conv。
受到上一节dropout的启发,我们知道现在的模型其实是存在比较严重的过拟合现象的,即使加入了dropout层,训练集和验证集上的指标依然存在4个点的差距,所以我继续从降低过拟合的角度来入手。
降低过拟合最直接的方式当然是减少参数量,但我们本来就是轻量模型,参数每减一点都可能对性能有很大影响,所以如何减参数是需要谨慎考虑的。至于其他的正则化手段,不论是weight_decay还是增大dropout比例,我实验后无一例外也都掉点了。
最终我在分析可能导致过拟合的模块时,把目光集中到了shufflenetv2的最后一层上,作为一个为分类模型设计的backbone,在分类问题上提点的一个有效手段是,在输出的最后一层对特征进行升维。
以为例,模型最后一个stage输出的特征维度本身应该是464维的,但是最后用一个1x1卷积升到了1024维,如果是做分类问题的话,后面会接GAP层然后全连接层,目的是升高维度有利于多类别之间的特征学习,让特征在高维空间更容易区分开,但对于我们的关键点定位任务,其实并不需要这么高的特征维度。
考虑到RLE用来预测sigma的流程跟分类问题比较相似(GAP+FC),最终我选择了让backbone输出两张特征图,1024维的特征用来预测sigma,464维的特征送去做定位,最终推理速度为:
6.3实验小结五最终的实验效果如下:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
19-1
320x320,w/o1024d,deconv(256,16)
0.8582
84.0958
24.3950
19-2
320x320,w/o1024d,deconv(256)
0.8563
84.1036
24.4913
可以看到过拟合现象被进一步缓解,在接近5ms的速度提升的同时精度几乎没有降低,至此,我们以12.3ms的推理速度让基于regression方法的模型,达到了超越heatmap方法的精度,且推理速度快了近3倍。
7.不讲武德系列代码框架和模型搭好以后,由于我所有的优化都是与backbone无关的,可以随意替换更强的backbone,恰好最近mt-yolov6开源,我也紧跟时事随手测了一波。
yolov6-n模型的backbone加到本模型上推理速度大概14.7ms,参数量比shufflenetv2多了接近4MiB,最终性能提升了1个点:
实验序号
方法
acc_pose
PCKh
PCKh@0.1
20
320x320,efficientrep-n
0.83075
84.8217
26.1332
由于是用的一样的训练配置,可以看到训练集上指标还低于验证集,所以按理来说还有很大的调参空间,性能应该还能再继续提升一波。这个提升其实也不意外,对backbone加重参数技巧带来提点也是目前业务上必加的技巧了,由于本文的目的不在于改进backbone,而且backbone替换带来的涨点,跟原先基于shufflenetv2的heatmap方法精度进行对比也不公平,所以这里只是稍微展示一下效果。
8.一些没有起到作用的技术8.1DebiasedIPR在ICCV2021中有一篇工作通过数学方法对Softmax引入的误差进行了修正,论文中取得了不错的效果,但是我自己根据论文理解实现的版本效果并不理想,我已向作者发邮件进行了联系,希望能得到作者的帮助。
8.2Sampling-ArgmaxSampling-Argmax是RLE作者在NeuraIPS2021的工作,核心思想是对IPR的改进,针对IPR梯度不稳定的问题,设计了一个用重参数技巧来解决的方案,能提供更加稳定的梯度。
在我的实验中,该方法的确可以正常训练,但是最终取得的效果并没有直接用高斯分布监督的精度高。
实验序号
方法
acc_pose
PCKh
PCKh@0.1
21
320x320,w/o1024d,sa-simdr+sampling-argmax(tri,n=10)+rle*
0.8363
83.4973
22.7973
8.3TokenPoseTokenPose也是Transformer火了之后很自然的一篇工作,原文的主旨是将TransformerDecoder作为Head来预测Heatmap,在本项目中我们也可以很自然地用来预测SimDR表征,在这里我实验了两种方案,第一种是直接用TokenPose替换deconv层,即backbone提取出来的特征直接送给TokenPose,这样的好处是可以节省计算量,坏处是转换比较激进,直觉上感觉性能可能会不如deconv后的效果,所以又实验了第二种方案,先deconv后再进行TokenPose。
不过考虑到延迟问题,响应的超参数肯定也需要做调整。这里第一种使用的patchsize为2x2,第二种则需要改为8x8,即使如此第二种的推理速度也还是慢了不少。
直接输入版本4层版本3层
另外我注意到加了tokenpose后训练初期的效果差了很多,毕竟基于卷积得到的预训练特征对于mlp众多的transformer而言确实效果有限。
{"mode":"train","epoch":1,"iter":100,"lr":0.0001,"memory":3678,"data_time":0.07201,"reg_loss":26.4141,"acc_pose":0.07084,"loss":26.4141,"time":1.00655}{"mode":"train","epoch":2,"iter":100,"lr":0.00027,"memory":3678,"data_time":0.0604,"reg_loss":-33.63047,"acc_pose":0.19622,"loss":-33.63047,"time":0.96591}{"mode":"train","epoch":3,"iter":100,"lr":0.00045,"memory":3678,"data_time":0.06313,"reg_loss":-47.45935,"acc_pose":0.24253,"loss":-47.45935,"time":0.92242}{"mode":"train","epoch":4,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.06104,"reg_loss":-62.17723,"acc_pose":0.39696,"loss":-62.17723,"time":0.91032}{"mode":"train","epoch":5,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.06199,"reg_loss":-72.71697,"acc_pose":0.49004,"loss":-72.71697,"time":0.95145}{"mode":"train","epoch":6,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.05916,"reg_loss":-76.37753,"acc_pose":0.51472,"loss":-76.37753,"time":0.96653}{"mode":"train","epoch":7,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.063,"reg_loss":-78.6295,"acc_pose":0.53032,"loss":-78.6295,"time":0.9599}{"mode":"train","epoch":8,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.05949,"reg_loss":-79.18694,"acc_pose":0.53346,"loss":-79.18694,"time":1.02493}{"mode":"train","epoch":9,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.06176,"reg_loss":-82.34116,"acc_pose":0.55703,"loss":-82.34116,"time":1.03079}{"mode":"train","epoch":10,"iter":100,"lr":0.0005,"memory":3678,"data_time":0.06209,"reg_loss":-83.11978,"acc_pose":0.56071,"loss":-83.11978,"time":0.95358}实验序号
方法
acc_pose
PCKh
PCKh@0.1
22
256x256,tokenpose(2x2,depth=4)+rle*
0.8545
82.2795
21.3635
实验效果方面,加了tokenpose后模型其实并没有涨点,反倒是掉了0.3个点,在mpii这种小数据集上要从头训transformer还是有点太勉强了。根据我过去的个人经验,如果数据量能达到百万级别,加transformer是可以带来性能提升的。
9.结语在本文中,我围绕算法对一个经典的轻量姿态估计模型进行了优化,最终以cpu下单线程推理12ms的速度取得了超越heatmap方法的精度,以及接近3倍的速度提升。而在实际项目中,其实还会在backbone、数据处理、部署代码等方面进行优化,推理速度和精度还有进一步大幅提升的空间,如果有机会我还会继续总结成文章分享出来。
这篇文章虽然一开始有预料到篇幅会不短,但整个过程还是几乎占用了我整个离职假期,文章前后写了三版,由于一开始消融实验做得比较凌乱,最后又全部从头跑了一遍确认所有技术的有效性,最后删掉了很多我感觉意义不大,或者跟本文主旨关联不强的内容,算是为我之前的学习所得做了一个严肃的总结。
对我个人而言,这个过程让我对mmpose的掌握加深了很多,以后可以轻松基于mmpose复现各种新的方法,也方便我今后对新的技术进行横向对比,这是我最大的收获。
最后,如果觉得我写的东西对你有所帮助,希望能点赞鼓励一下,感谢支持~